KDZNR网

 找回密码
 立即注册
搜索
热搜: 活动 交友 discuz
查看: 84|回复: 0

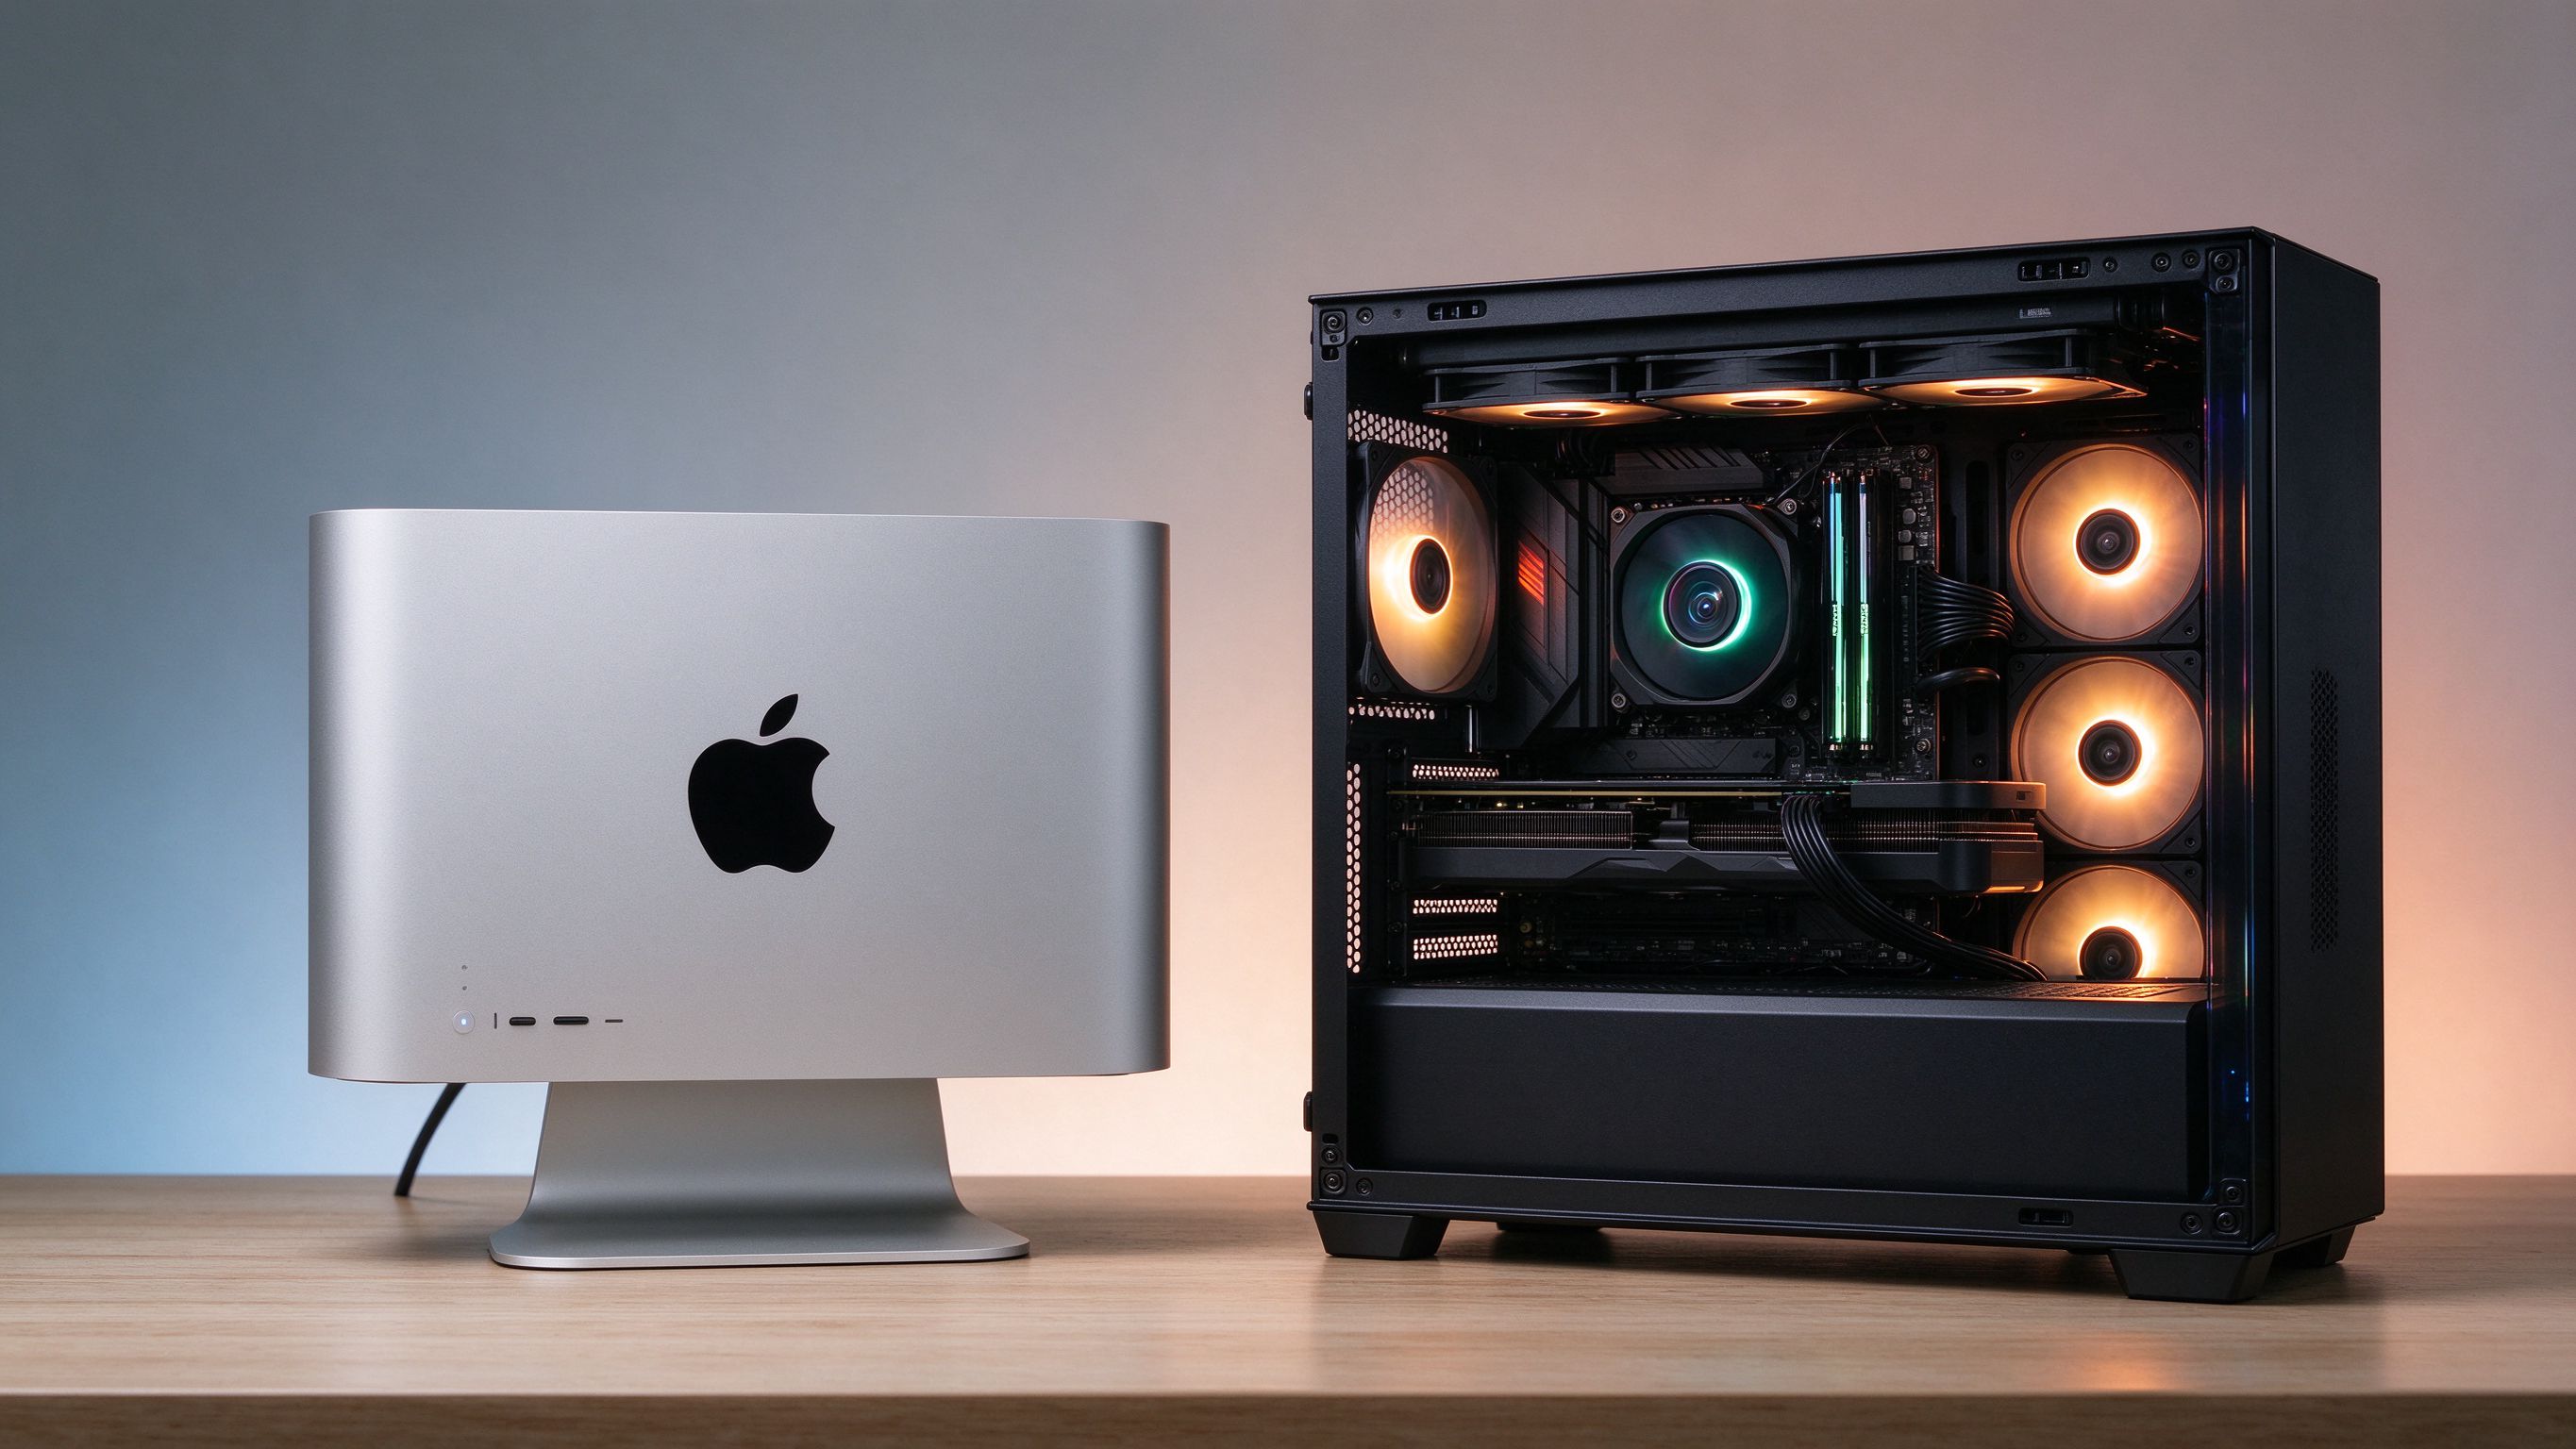
Apple 芯片 vs NVIDIA:本地 AI 之争的两个问题

[复制链接]

358

主题

0

回帖

1210

积分

超级版主

Rank: 8Rank: 8

积分
1210
发表于 2026-10-19 12:30:29 | 显示全部楼层 |阅读模式


装得下是内存,跑得快是带宽。4-bit 下每 10 亿参数约需 0.6GB,加上对话空间。NVIDIA 的取舍是"卡上放少量极快的内存":5090 有 32GB,GeForce 没有更大的;Mac 是"处理器与显卡共享一个大池":Mac Studio 到 128GB(M5 Max)/256GB(M5 Ultra),带宽 614GB/s / 1.2TB/s。同模型装得下时 NVIDIA 快得多:llama.cpp 社区基准里,Llama 2 7B 4-bit,RTX 5090 写 290 token/秒,M5 Max 写 120——旗舰卡快 2.4 倍;但读 prompt 更悬殊:5090 每秒读 14073 token,M5 Max 3220,快 4.4 倍,长 prompt(编码代理、文档工作,每一步都重发几万 token)特别吃亏。Apple 在追:M5 Ultra 声称读 prompt 比 M3 Ultra 快 4 倍,Ollama 换 MLX 后生成速度翻倍(58→112)。
模型超过 32GB 时攻守易势:gpt-oss-120b 标准 4-bit 是 59GB,几乎两个 5090 才装得下;软件把装不下的部分丢进系统内存让 CPU 慢慢算,5090 只剩约 30 token/秒,而 M3 Ultra Mac Studio 全体住在统一内存里,Jeff Geerling 实测 78 token/秒——小模型输 2.4 倍的大 Mac


在模型上赢约 2.6 倍。再往上 5090 直接出局:同一台 Mac 跑 Qwen3 235B(132GB 文件)26 token/秒、DeepSeek R1(377GB)20 token/秒,任何 GeForce 都载不了。NVIDIA 想对等容量得掏钱:96GB 的 RTX PRO 6000 Blackwell 跑 120B 达 196 token/秒、约 2 万美元。
按"每 GB 多少钱"算更直白:5090 32GB 6996 美元 ≈ 219 美元/GB(还只是卡);128GB Mac Studio 5099 美元整机、GPU 可用约 96GB ≈ 53 美元/GB——Mac 便宜 4 倍,优势从消费级显卡的 32GB 上限处开始。图像/视频是 Mac 最差的场景:HunyuanVideo 要求"带 CUDA 的 NVIDIA GPU"、Wan 2.2 只提 NVIDIA、FlashAttention 依赖 CUDA;ComfyUI 能跑 Metal 但慢,且没有同设置独立对比测试。功耗:Mac Studio 待机 7W/满载 200W,5090 单卡 575W 需 1000W 电源;但按 token 算两者几乎打平(M3 Ultra 226W/104 token每秒 vs 4090 PC 338W/183)。结论:语言模型超过约 32GB 买 Mac;图像/视频/长 prompt 买 NVIDIA;日常聊天两边都快到追不上你读字速度。
回复

使用道具 举报

您需要登录后才可以回帖 登录 | 立即注册

本版积分规则

Archiver|手机版|KDZNR网

GMT+8, 2026-11-9 05:08 , Processed in 0.062925 second(s), 18 queries .

Powered by Discuz! X3.4

© 2001-2023 Discuz! Team.
快速回复 返回顶部 返回列表