KDZNR网

 找回密码
 立即注册
搜索
热搜: 活动 交友 discuz
查看: 15|回复: 0

本地运行 Gemma 4:五种尺寸一条命令上手

[复制链接]
匿名
匿名  发表于 昨天 17:49 |阅读模式
谷歌最强的开源模型放弃了自定义许可证,改用标准的 Apache 2.0。五种尺寸,每种一条命令,从手机到工作站都能跑。


Gemma 4 最大的升级不在权重里,而在细则中

许可证的前后对比:

之前(Gemma 使用条款)|之后(Apache 2.0)
使用受 Gemma 禁止使用政策约束|可自由运行、修改、微调、出售
谷歌可远程或以其他方式限制你的使用|权重上没有附带单独的使用政策
再分发时必须把这些条款沿链条传递下去|没有谷歌的任何东西需要你转嫁给用户

删除线部分是旧的 Gemma 使用条款,它仍然适用于 Gemma 1 到 3n 以及各种专用模型。新增部分则属于 Gemma 4 核心家族,自发布起就采用 Apache 2.0。

谷歌发布了有史以来最强的开源模型,同时一并删掉了自己的许可证。两年来,每一次下载 Gemma 都附带作业:一份自定义的"Gemma 使用条款"、一项谷歌可以执行的使用政策,以及一条允许公司远程限制你使用的条款。Gemma 4 把这一切全部抛弃,改用标准的 Apache 2.0——正是日常开源软件背后那份许可证。

我们曾在"谷歌 Gemma 详解"一文中梳理过这个家族。本文是它的实战姊妹篇:五种尺寸里哪一款真正匹配你手头的机器、每一款运行的那条命令、新许可证到底允许你发布什么产品,以及在什么情况下另一个竞争家族仍然是更好的选择。

五种尺寸覆盖从手机到主机的全部场景

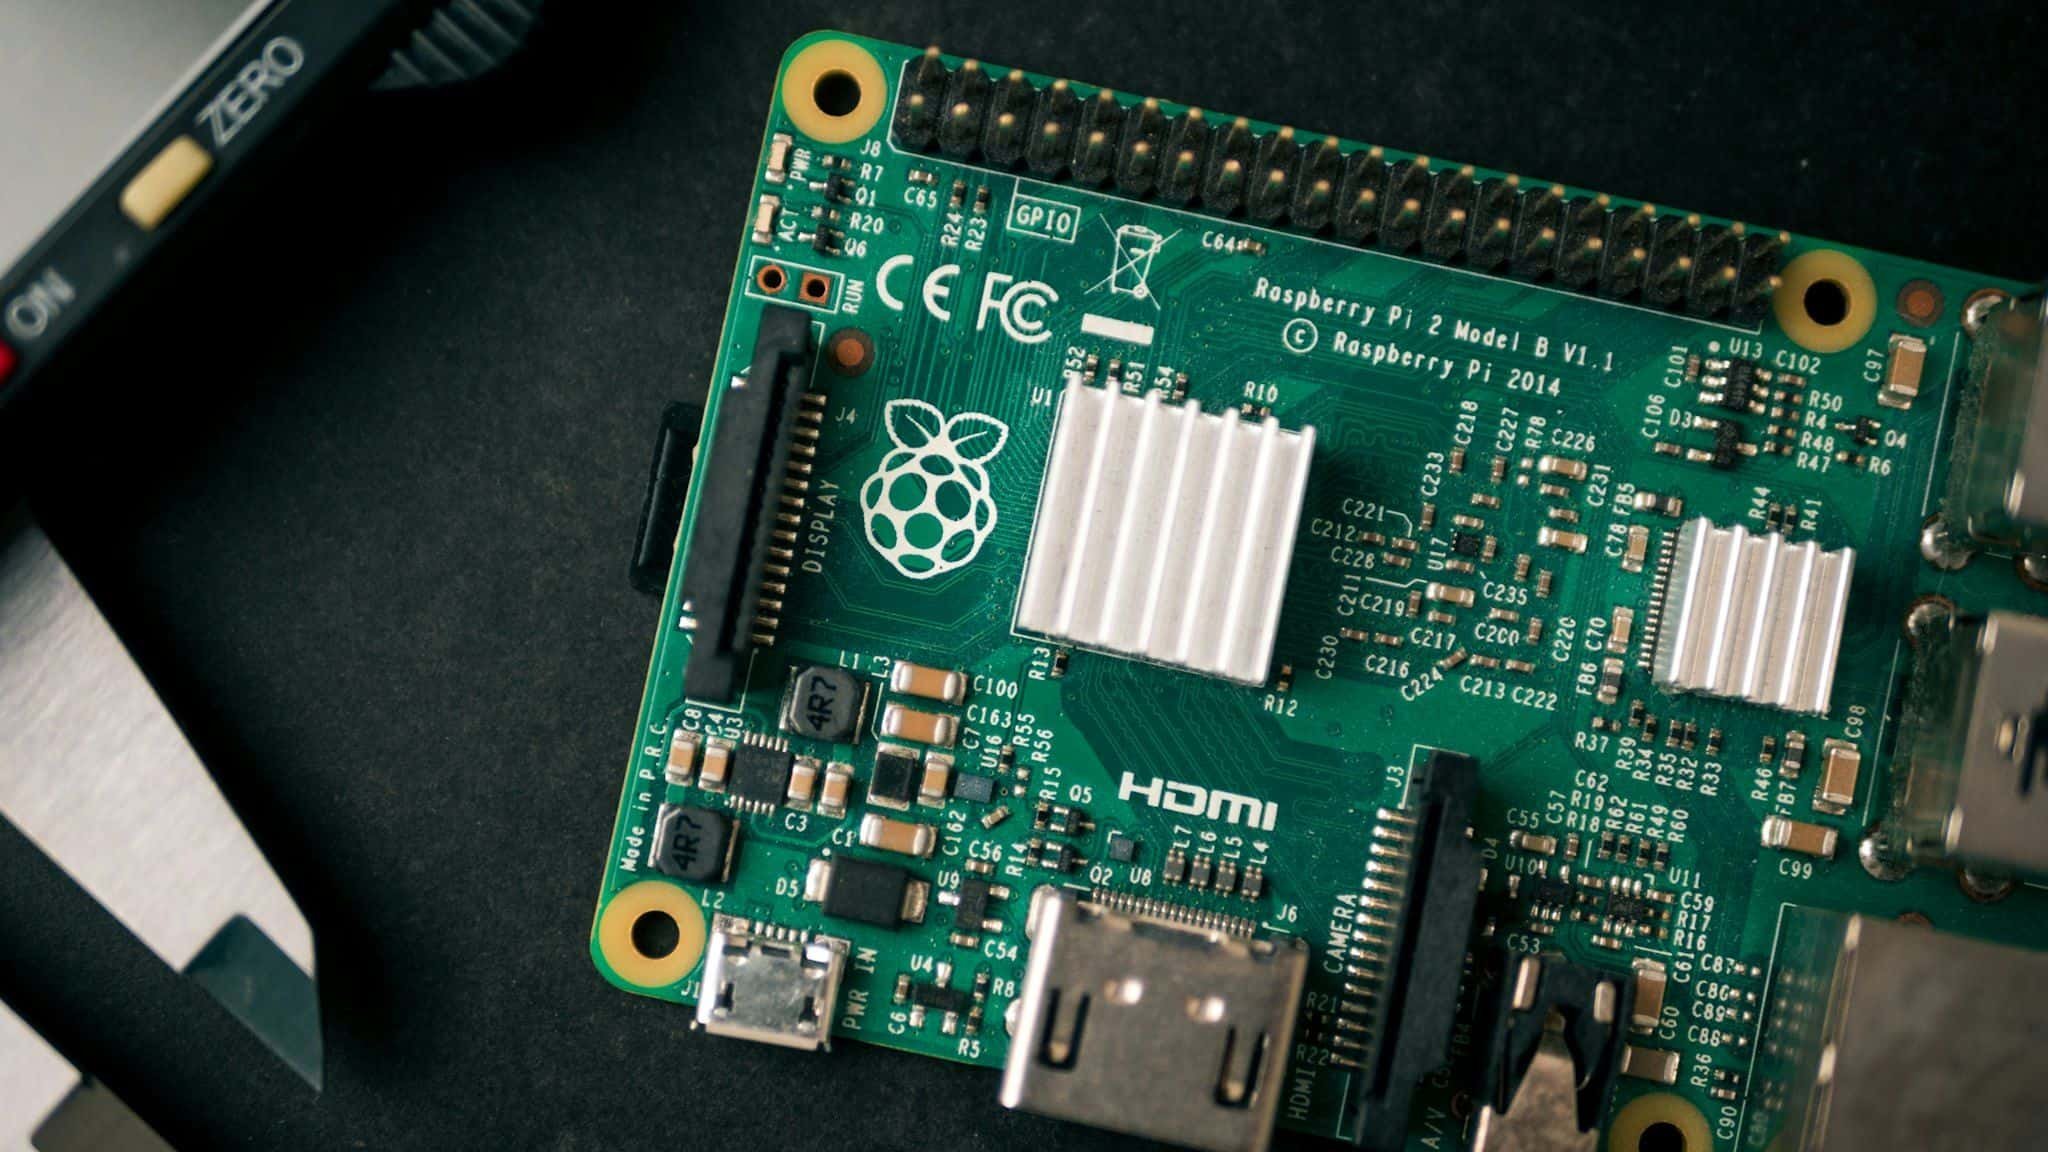
核心家族有五个模型,划分依据是硬件而非营销档位。最底下是两款边缘模型 Gemma 4 E2B 和 E4B。E 代表 effective(有效),是谷歌对那些常驻内存占用相当于 2B 或 4B 模型、而非完整参数规模的模型的命名。谷歌在发布博文中把它们定位在手机、树莓派开发板和 Jetson Orin Nano 设备上,配备 128K token 上下文窗口,并且在家族中独一无二地支持原生音频输入。

梯子最底层比多数人预想的还要低:E2B 边缘模型瞄准的就是这类单板开发板。

别把"边缘"读成"玩具"。音频输入意味着 E 系列模型可以在完全没有网络连接的设备上转录语音备忘录或回答口语提问,而且家族里每一款都能读图,所以"这张报错截图是什么意思"在最小档位也能用。这种组合——在售价低于一台游戏机的硬件上实现完整的多模态理解——放在两年前会被当成科幻。

再往上是三大主力。26B 是家族的效率担当:采用混合专家(MoE)设计,每个 token 只激活约 38 亿参数,因此以小模型的速度作答,得分却接近家族顶端。31B 是稠密模型,被打造为质量天花板,也是谷歌推荐用于严肃微调的基座;发布时它在 LMArena 文本排行榜上位列所有开源模型第 3,26B 位列第 6。两者都原生读图,并把上下文窗口扩展到 256K token。而在中间位置是 12B,它值得单独一节,因为对大多数读者来说它才是值得关注的理由。

家族级别的一个额外福利在发布两周后落地:多 token 预测起草器,这是一些小型伴随模型,能提前起草数个 token,再由主模型一次性验证。谷歌报告称生成速度最高提升约 3 倍,输出完全一致。在本地硬件上,每个 token 都要和你的内存带宽搏斗,这个提速就是"盯着光标干等"和"直接读到答案"之间的区别。

Gemma 4 阵容一览(每一行都是 Apache 2.0):

模型|上下文|理解能力|拉取大小|用途
Gemma 4 E2B|128K|文本·图像·音频|7.2 GB|手机、树莓派、Jetson:完整多模态、完全离线
Gemma 4 E4B|128K|文本·图像·音频|9.6 GB|最强边缘档位;Ollama 默认的 gemma4
Gemma 4 12B|256K|文本·图像·音频·视频|7.6 GB|笔记本日常主力,后加入家族
Gemma 4 26B(MoE)|256K|文本·图像|18 GB|发布时开源第 6;每 token 约 38 亿激活参数
Gemma 4 31B|256K|文本·图像|20 GB|家族天花板;发布时 LMArena 开源模型第 3

上下文窗口和模态来自谷歌发布说明;拉取大小是 Ollama 默认的 4-bit 量化版。E 系列也接受音频;12B 还接受视频。


12B 是谷歌首发时没有带上的日常主力

最初的阵容中间有个空缺:从 9.6 GB 的边缘模型到 18 GB 的工作站拉取之间什么都没有。谷歌用 Gemma 4 12B 补上了这个缺口,结果它成了家族里最贴合笔记本的模型。它是一个稠密 12B,在单一架构中理解文本、图像、音频和视频,携带完整的 256K 上下文窗口,尺寸专为配备 16 GB 显存或统一内存的机器设计。一台中端 MacBook 或游戏本就能跨过这条线。

工程上的窍门是谷歌所说的"统一、无编码器设计"。大多数多模态模型把一个独立的视觉编码器外挂到语言模型上;12B 用一个 3500 万参数的嵌入器取代了那个环节——约为同类模型编码器的十六分之一大小——然后把原始图像 patch 和音频帧直接喂进 transformer。输入和模型之间的机械装置越少,延迟越低,而这一点在该模型瞄准的硬件上最为关键。下载体积上也能看出来:7.6 GB 的 12B 拉取体积反而比 E4B 边缘模型还小,却携带两倍上下文并新增了视频输入。

对技术好奇者,开发者指南公开了内部管线。图像以原始 48×48 像素 patch 加坐标查询的形式进入,不经过编码器;音频以 16 kHz 信号切成 40 毫秒帧的形式进入。谷歌的演示让模型处理一段五分钟视频,每秒采样一帧共 313 帧并附带同步音频,然后就发生了什么提问。这不是派对把戏;这是会议记录和课程录制的场景,而它跑在一台笔记本上。

12B 的自然栖息地:在一台普通笔记本上做文档问答,完全不碰云。

如果你想让一个模型整天挂着不卸载(聊天、总结 PDF、描述截图、转录语音备忘录、就讲座录音回答问题),就是它了。它是第一款原生支持音频的中型 Gemma,也是家族中唯一会看视频的档位。模型页面有完整规格表。

让命令匹配你的内存,而不是你的雄心

下面所有内容都假设你使用 Ollama——就是我们本地模型指南全程使用的那条一条命令运行器。装上它,选你那一行,跑命令。拉取大小是 Ollama 默认的 4-bit 量化版;如果你对这个词陌生,量化就是那种把 12B 模型压进 7.6 GB 而几乎看不出质量损失的压缩技术。

每台机器一条命令:

你的机器|命令|拉取大小|你得到什么
8 GB 笔记本·树莓派|ollama run gemma4:e2b|7.2 GB|边缘模型:听音频、读图像、离线运行
16 GB 笔记本|ollama run gemma4:e4b|9.6 GB|默认档位;裸 gemma4 命令就落在这
16 GB 笔记本或 Mac|ollama run gemma4:12b|7.6 GB|日常主力:256K 上下文、音频和视频输入
32 GB 工作站|ollama run gemma4:26b|18 GB|MoE:小模型速度下接近天花板质量
32 GB 以上·24 GB 显存|ollama run gemma4:31b|20 GB|天花板:有史以来最强的开源 Gemma

机器档位假设模型与你的操作系统和浏览器共享内存。在 Apple Silicon 上,mlx 标签(例如 gemma4:12b-mlx)以更快速度运行同样的模型。

诚实的 sizing 规则:拉取大小大致等于权重占用的内存,而你的操作系统、浏览器和模型的工作上下文都要争抢剩余部分。留出几 GB 余量,拿不准就降一档。装得下的模型能跑;换页到磁盘的模型会爬。

Ollama 是最短路径,但不是唯一路径。LM Studio 在图形界面后拉取同一批 checkpoint,并提供内存适配提示。在 Apple Silicon 上,表注里提到的 MLX 构建是快速通道。爱折腾的人可以直接用 llama.cpp 配合 Hugging Face 上的 GGUF 文件,谷歌自家的 LiteRT-LM 运行时一条 litert-lm serve 命令就能撑起一个兼容 OpenAI 接口的本地服务器——这意味着任何说标准聊天 API 的客户端都可以指向你的笔记本而不是云端点。无论用哪个运行时,底下都是同一个 Apache 许可的模型。

这个家族特有的一个警告:256K 上下文是预算,不是免费升级。上下文在权重之外还要消耗内存,填满二十五万 token 会给占用加上好几 GB。Ollama 默认窗口也比模型支持的短得多,所以长文档会被悄悄截断,直到你主动调大。我们的 RAM 和 VRAM 指南讲过这笔账;简短版本是:调到你实际需要的上下文,一分不多。

Apache 2.0 改变的是你能发布什么,而不是它怎么跑

许可证翻转很容易被低估成"纸面文章"。以下是旧的 Gemma 使用条款附加在每一个早期 Gemma 上、至今仍附加在 Gemma 3 上的内容:你的使用受一份谷歌可以更新的禁止使用政策约束;谷歌保留限制它认为违反协议的使用的权利,"远程或以其他方式";如果你基于该模型构建,必须把这些同样的限制转嫁给你自己的用户。这些并没有让 Gemma 3 不可用,但每一个产品决策都带着一个小小的星号。

Gemma 4 核心没有星号。Apache 2.0 是一份标准的、OSI 批准的许可证:运行它、在自己数据上微调、嵌入商业产品、卖掉那个产品、保留成果。权重上没有附带使用政策,没有远程限制条款,没有谷歌的东西需要你服务条款携带。它还授予专利权,这是法务团队偏爱它的隐秘原因。对一家公司来说,这把 Gemma 4 从"先问法务"挪到了和构建中已有的开源库同一个筐里。

Apache 2.0 不是零义务,所以诚实地列出来:如果你再分发模型或微调版,要随附许可证文本和版权声明,并注明你改了什么。这是记账,不是控制;谷歌对你构建什么没有发言权。与市场其余部分的对比非常鲜明。Meta 的 Llama 许可证带有 7 亿用户上限和品牌规则;Gemma 3 带有上述条款。在大实验室的开源家族中,现在只有 Gemma 4 核心能和 MIT 许可的 Phi 系列一样做到"读一遍就放下"。

许可证接缝在这里最要紧:小团队现在可以基于 Gemma 4 构建,而不需要律师在环。

需要分清的接缝:Apache 2.0 只覆盖 Gemma 4 核心模型。专用 Gemma(ShieldGemma、PaliGemma、CodeGemma、EmbeddingGemma、FunctionGemma 以及其余专用阵容)仍列在旧 Gemma 条款附录里,Gemma 3 本身从未改变。如果你的产品触及某个专用模型,旧规则对那一部分仍然适用。检查你拉取的确切 checkpoint 上的许可证,而不是博客文章上的家族名。

坦白说 Gemma 4 会输在哪里

开源第 3 的排名意味着仍有东西在它上面,在你押注之前值得了解这个模式。Gemma 4 是通才。推理优先的产品线——比如 DeepSeek 的 R 系列——被设计成在推理时花多得多的 token 去思考,这种设计让它们在最难的数学和代码上保持领先。如果工作是竞赛级解题,专用推理器仍然是更好的工具。

广度是另一个侧翼。Qwen 比谷歌提供更多尺寸和更多专用变体,所以如果你的约束很不寻常(面向微控制器级设备的 0.6B、专用编程模型),那个全家桶大概率有更贴近的选择。在最小端,Phi 的推理微调小模型在数学上仍比 Gemma 边缘模型表现更抢眼。还要注意 Gemma 4 完全不做什么:它理解图像、音频和视频,但只输出文本。它会描述你的照片,永远不会生成一张。

家族内部还有一个怪癖:听力能力不会随升级放大。只有边缘模型和 12B 接受音频;26B 和 31B 只有文本加图像。升级硬件、往上走一档,你在 12B 上搭好的语音备忘录工作流就停了。如果音频输入是你用途的核心,12B 不是省钱之选,它就是天花板。

今晚就装这一个

决策很好压缩。在一台普通的 16 GB 机器上,拉 gemma4:12b 然后停止阅读;它是家族里每 GB 能力最高的,也是唯一能听能看的档位。在 8 GB 笔记本或单板机上,用 gemma4:e2b。有工作站或 24 GB 显存,用 gemma4:31b,不订阅就能摸到前沿的边。还在家族之间纠结?本地模型流程图就是为那一刻存在的。

更大的要点是首图里那个。开源模型的能力每季度都在提升;开源模型的条款几乎从不。谷歌的开源家族在那个通常只会变差的轴上悄悄改进了,而你这个周末在它上面构建的东西,以一年前不可能的方式真正属于你。值得用一条命令和八 GB 空间去发现这对你意味着什么。
回复

使用道具 举报

您需要登录后才可以回帖 登录 | 立即注册

本版积分规则

Archiver|手机版|小黑屋|KDZNR网

GMT+8, 2026-9-26 22:27 , Processed in 0.053190 second(s), 20 queries .

Powered by Discuz! X3.4

© 2001-2023 Discuz! Team.
快速回复 返回顶部 返回列表