塔式机到 32 GB 就到头,迷你机能摸到 96 GB,而贴最大 AI 贴纸的那台两者都跑不动。先选形状,再选型号。
走进任何一家电器店,贴最大“AI”贴纸的台式机,恰恰是最跑不动正经 AI 模型的那台。贴纸只说明这台机器有一颗神经网络处理单元(NPU),一颗为跑 Windows 自带的小模型而生的小芯片。它对那个决定 14B、32B 还是 70B 模型能不能装下的数字——显卡能摸到多少显存——只字未提。
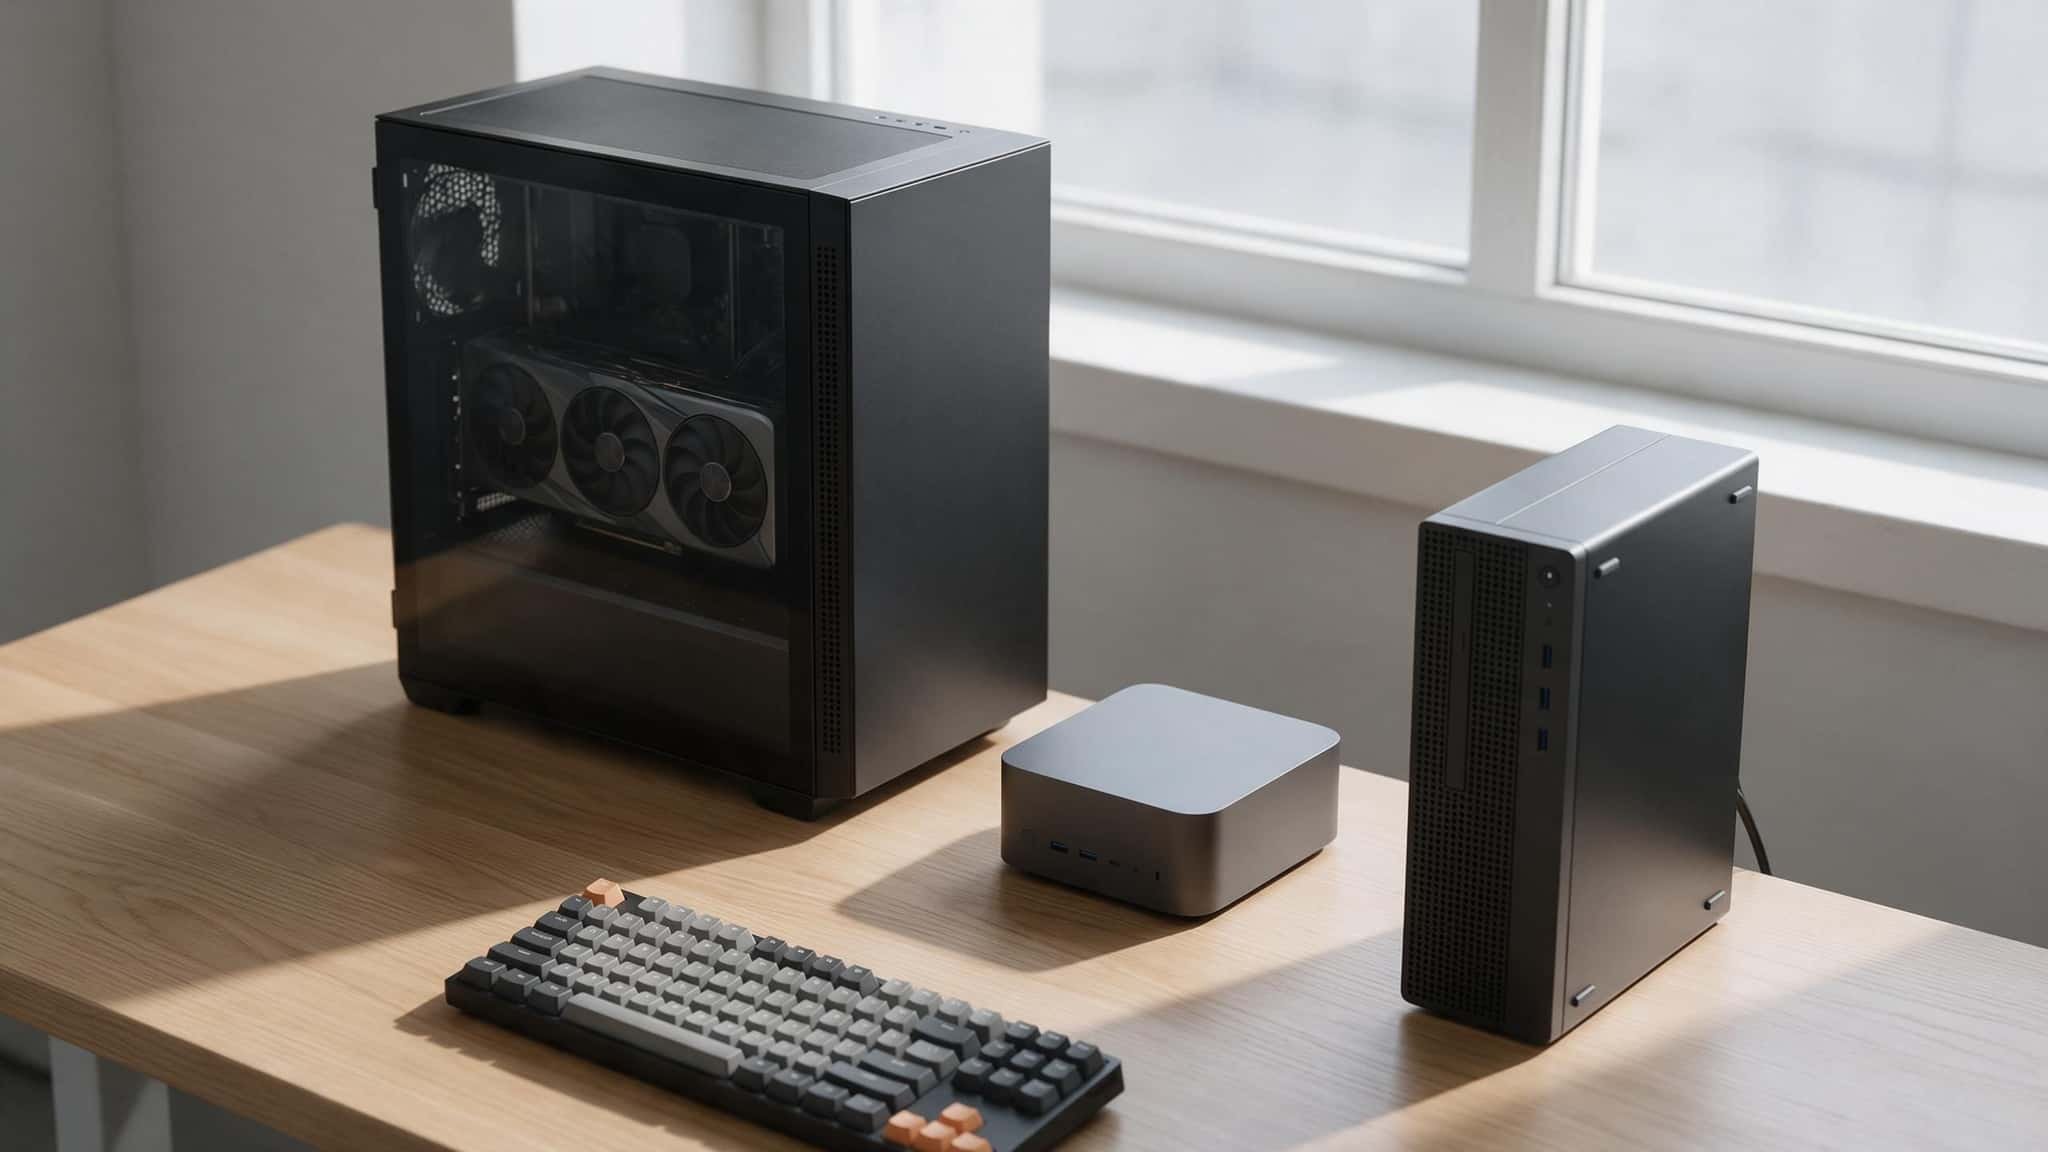
正是这个数字,让 Windows 的购买决定成了三种机器形状之间的选择,而不是品牌之间的选择。带独立显卡的塔式机给你一条固定的显存梯子,顶端停在 32 GB。基于 AMD Strix Halo 芯片的迷你主机,处理器和显卡共享一个最高 128 GB 的内存池,是越过 32 GB 唯一合理的 Windows 路。而 Copilot+“AI PC”是一台不错的办公电脑,却不是人们说“本地 AI”时指的那些模型的合适工具。先选形状,具体型号是细节。本文写给想买一台成品台式机、开箱就用的人;想自己攒机的话,攒机指南走的是同一套显存逻辑。
三种 Windows 台式机,贴纸贴错了对象
语言模型必须整个躺在显卡能读到的内存里,而且它每生成一个词都要把整个模型读一遍。就是这一个事实,把所有 Windows 台式机分成三种形状。
GPU 塔式机。传统机箱配一张 NVIDIA 或 AMD 独显。卡自带快而固定的显存,模型必须装进去。你那 64 GB 系统内存不算数。塔式机是单位 token 最快、16 GB 以内最划算的形状,各种模型都能跑,包括图像和视频生成,不折腾。
统一内存迷你主机。一本厚书大小的盒子,围绕 AMD Ryzen AI Max+ 395(大家叫它 Strix Halo)做成,处理器和显卡共享一个焊死的内存池。在 128 GB 的机器上,你能分给显卡一侧最高 96 GB。消费级塔式机没有任何东西能接近这个数,但内存更慢,所以大模型是步行速度。
NPU“AI PC”。一台轻薄台式机或一体机,处理器的神经网络单元过了微软给 Copilot+ 徽章定的每秒 40 万亿次运算门槛。NPU 加速 Windows 自带的模型,对那些功能是实打实的能效收益。它不是跑 12B 到 70B 模型的地方,下文会讲为什么。
一句话版:你的野心停在 32B 以内,买塔式机;停不住,买 Strix Halo 盒子;买 AI PC 的理由和本地 AI 无关。
塔式机是一条显存梯子,唯独 24 GB 这一级缺了
NVIDIA 当前的桌面显卡恰好只有四种显存规格。在 NVIDIA 自家对比表里,RTX 5050、5060 和一款 5060 Ti 是 8 GB;5070 是 12 GB;16 GB 的 5060 Ti、5070 Ti 和 5080 是 16 GB;5090 是 32 GB。这一代没有 24 GB 的卡。AMD 消费级这边最高停在 16 GB 的 RX 9070 XT,它的 32 GB 入场券是一张工作站卡 Radeon AI PRO R9700——和 9070 XT 同一颗硅、显存翻倍,指导价 1299 美元。
缺掉的 24 GB 这一级之所以要命,是因为 24 GB 正是 27B 到 32B 模型变舒服的那一档。一个 32B 模型 4-bit 约 20 GB 权重加上下文。16 GB 装不下;32 GB 装下还有余量。这两档在价目表上的差距巨大,所以攒机指南仍把性价比买家引向二手 24 GB 的 RTX 3090 或 4090。买品牌整机的人没这个选项。全新塔式机要么停在 16 GB,要么跳到 32 GB。
桌面显卡梯子,按显存再按带宽排(列依次为:显卡|显存|带宽 GB/s|卡功耗/建议电源|街价|指导价):
RTX 5060 Ti 16 GB|16 GB|448|180 W / 600 W|$680(8GB 版追踪价)|$429
RTX 5070|12 GB|672|250 W / 650 W|$887|$549
RX 9070 XT|16 GB|640|304 W / 750 W|$799|$599
RTX 5070 Ti|16 GB|896|300 W / 750 W|$1,200|$749
RTX 5080|16 GB|960|360 W / 850 W|$1,299|$999
Radeon AI PRO R9700|32 GB|640|300 W / 750 W|$1,299|$1,299
RTX 5090|32 GB|1792|575 W / 1000 W|$5,997|$1,999
街价这一列是变化最大的。NVIDIA 的指导价还是发布时的数,但显存短缺把 RTX 5090 最低追踪街价推到 5997 美元,是 1999 美元指导价的三倍。5080 报 1299 美元,5070 Ti 报 1200 美元,5070 报 887 美元,连 8 GB 的 5060 Ti 都要 680 美元、比指导价高 79%。AMD 的 9070 XT 报 799 美元,指导价 599。
对买家两个推论。第一,16 GB 这一档才是性价比所在:一张 5070 Ti 或 9070 XT 装得下带长上下文的 14B 模型、还能舒服跑图像模型,街价只有 5090 的四分之一。第二,到了 32 GB 这一档,单买这张卡现在比买一台带同卡的整机还贵,这把通常的建议反过来了。想要 5090,就买在塔式机里。
品牌整机三条线,看机箱顶得住哪张卡
Windows 三大厂商各卖一台游戏塔式机兼作本地 AI 盒子,读它们目录有用的方式,是看每个机箱最高接受哪张卡。
戴尔。Alienware 的 Aurora 从 1849.99 美元起,最高配到 RTX 5080,所以无论怎么配都是一台 16 GB 机器。更大的 Area-51 Intel 版从 4199.99 美元起、AMD 版从 4099.99 美元起,最高上到 RTX 5090。这个分野就是整条产品线的全部故事:中塔是 16 GB 盒子,全塔是 32 GB 盒子。
惠普。OMEN 台式机画了同样的线。OMEN 35L 顶到 RTX 5080,小的 OMEN 16L 顶到 8 GB 的 5060 Ti,只有 OMEN MAX 45L 上到 5090,AMD 选项是 RX 9070 XT。一项评测测得 MAX 45L 起价 3199 美元,一套 5090、64 GB 内存、4 TB 的配置不打折约 6500 美元。
联想。Legion Tower 7i Gen 10 是联想的 5090 机箱;亚马逊 listing 上那套把卡配 64 GB 内存和 1200 W 电源,两样都正好。联想更小的 Tower 5i 系列停在 5070 Ti。
三家的价格每周都动,促销价通常才是真价。不变的是每个机箱的上限,所以先定 16 GB 还是 32 GB,再打开配置器。预期基础价往上飘:IDC 曾转达联想、戴尔、惠普、宏碁、华硕警告涨价 15% 到 20%,因为 AI 数据中心在吸走内存供应;TrendForce 预计 DRAM 合约价在上季度大涨之后本季还要再涨 13% 到 18%。
越过 24 GB,Windows 的路是统一内存迷你主机
AMD Ryzen AI Max+ 395 本是笔记本级芯片,结果成了今年最有意思的桌面部件。按 AMD 规格页,它把 16 核处理器和一颗 40 单元的 Radeon 8060S 显卡引擎配在一起,最高 128 GB LPDDR5x、256 位总线。显卡一侧没有自己的显存,从池子里借。AMD 的可变显存 FAQ 把 128 GB 系统上的上限定在 96 GB、带宽 256 GB/s,在 Windows 上你在 Adrenalin 驱动软件里调这个分配。
把这两个数字对照塔式机梯子看。96 GB 是一张 RTX 5090 的三倍,所以 4-bit 的 70B 模型(约 43 GB)装下还有上下文余量,120B 混合专家模型(约 65 GB)也装得下。但 256 GB/s 是 5090 那 1792 GB/s 的七分之一,而生成速度跟着带宽走。这个盒子装得下塔式机装不下的模型,却把两者都装得下的模型跑出一小截速度。
公开的生成速度,单位 token/秒(紫是 128 GB Strix Halo 迷你主机,即 HP Z2 Mini G1a;琥珀是桌面 RTX 5090;模型和框架不同,只当量级看;每秒 20 以上就比多数人阅读快):
7–8B|两者都装得下|Strix Halo 37|RTX 5090 186
14B|两者都装得下|Strix Halo 19|RTX 5090 124
32B 稠密|两者都装得下,5090 在 32 GB|Strix Halo 9|RTX 5090 61
70B 稠密|32 GB 装不下|Strix Halo 4|RTX 5090 跑不了
120B MoE|32 GB 装不下|Strix Halo 40|RTX 5090 跑不了
迷你主机的数字用的是 StorageReview 测 HP Z2 Mini G1a 的结果:7B 模型每秒 36.86 token,32B 每秒 9.38,70B 每秒 4.24,gpt-oss-120b 接近每秒 40——后者因为混合专家设计每个 token 只激活几十亿参数。塔式机用的是 Hardware Corner 跑 RTX 5090 的数:Qwen3 8B 每秒 185.91,14B 每秒 123.79,稠密 32B 每秒 61.38。70B 和 120B 两行塔式机空着,因为它们装不进 32 GB——这个空格本身就是选形状的全部理由。
三台机器把这颗芯片做成桌面外壳。GMKtec 的 EVO-X2 标价 2199.99 美元(原价 2599.99),预装 Windows 11 Pro 出货。HP 的 Z2 Mini G1a 是工作站取向,带 ECC 内存、同样 96 GB 显存上限;StorageReview 测的那台 128 GB 卖 3342.65 美元。Framework Desktop 用一行话讲完显存短缺的故事:128 GB 型号从 1999 美元涨到 2459 美元,配置页上又挂到 3449 美元且缺货。买 128 GB,别买 64 GB:64 GB 的盒子分给 GPU 约 48 GB,装下 70B 就喘不过气。
DGX Spark 是开发机,不是更快的迷你主机
NVIDIA 自己也卖一台书大小的 128 GB 机器,很容易把它读成“带 CUDA 的 Strix Halo 盒子”。DGX Spark 规格页列了 Grace Blackwell GB10 芯片、128 GB 统一内存、273 GB/s、4 TB 存储、最高 1 petaflop 的 4-bit 算力、最高 2000 亿参数模型推理,四台可联起来到 7000 亿。带宽和 Strix Halo 同一档,所以大稠密模型的 token 速度也同一档。
两件事把它挡在 Windows 购买指南之外。它不跑 Windows:操作系统是 NVIDIA 的 DGX OS(Ubuntu 衍生版),处理器是 Arm,所以你的 Windows 软件带不过来。而且价格涨反了方向。NVIDIA 把 Founders Edition 从 3999 美元涨到 4699 美元,工作人员在自家论坛证实了这一变动,媒体把它和显存短缺挂钩。对想在 CUDA 工具链里微调模型、又想要和数据中心同一套栈的人,它是对的盒子。对想要一台能跑 70B 模型的 Windows 桌面的人,它是错的盒子。
另一条专业路是塔式机里的工作站卡。NVIDIA 的 RTX PRO 4500 Blackwell 给你 32 GB 纠错 GDDR7、896 GB/s、200 W;96 GB 的 RTX PRO 6000 存在,指导价据媒体报道 NVIDIA 翻倍到 16000 美元。对几乎所有人,一台五分之一价钱的 128 GB Strix Halo 盒子才是够到 96 GB 的理智方式。
Copilot+ NPU 伺候的是自带模型,不是 12B 到 70B 这一档
微软的 Copilot+ PC 开发者指南把这一类定义为:Windows 11 硬件、NPU 能每秒做 40 万亿次以上运算,为 Windows 自带的功能而生——实时翻译、图像生成、以及 Windows 自家文本工具背后的端侧语言模型。NPU 低功耗跑这些,在笔记本上这就是全部意义。在台式机上电池论点消失了,但功能照用。
NPU 不是为装你自己挑的多 GB 模型而生的。微软自家的端侧模型 Phi Silica 是最清楚的证据。它的文档说在 Copilot+ PC 上跑在 NPU 上,后来预览版起也支持普通 Windows 11 机器加独显:GeForce RTX 30 系或更新、或 Radeon RX 9060 或更新、6 GB 显存。反过来看这句话:一张早年的 6 GB 游戏卡就够跑微软的旗舰端侧模型了。NPU 是跑同一个小模型的更低功耗方式,不是跑更大模型的方式。下一节的运行时——Ollama、llama.cpp、本站所属的应用——没有一个用 NPU,它们都跑在 GPU 上。
Copilot+ 台式机现在确实有了。AMD 把 Ryzen AI PRO 400 系列带到 AM5 桌面插槽,带一颗过门槛的 50 TOPS NPU。这条发布有用的读法是插槽,不是 NPU:一块带 50 TOPS 芯片的 AM5 板子是一台很好的塔式机,而你一旦插进一张 16 GB 卡,本地 AI 活就由这张卡干,NPU 继续伺候 Windows 功能。想要 Windows 功能就买徽章;其余一切,买显卡。
Windows 这一层:25H2、一个驱动、选对后端
Windows 版本。微软的发布信息页显示目前在服三个版本,其中一个即将掉出支持。Windows 11 24H2 家庭版和专业版即将结束更新。25H2 是现有机器应该升到、新机器应该自带的版本。26H1 是特例:微软把它限定在新上市设备上,不作为对 24H2 或 25H2 机器的就地升级。
驱动。NVIDIA 同一张卡发两条驱动线,它自己的驱动页说得很白:Game Ready 给要新游戏首日支持的人,Studio 给在创作应用里求稳的人。两条线都跑下面所有运行时;对一台一跑模型就是几小时的机器,Studio 是更稳的选择。Ollama 硬件页要求 NVIDIA 驱动 550 或更新。AMD 这边直接从 AMD 装 Adrenalin,别信 Windows Update 给的版本;微软自家 Phi Silica 文档也讲了同样的道理:OEM 驱动太旧。
后端。模型运行时通过几种接口之一和显卡对话,在 Windows 上这个选择由卡替你做了。CUDA 是 NVIDIA 自家、支持最好的路。Vulkan 是跨厂商图形接口,llama.cpp 和 Ollama 也能拿来做计算,NVIDIA、AMD、Intel 卡都能跑。ROCm 是 AMD 对 CUDA 的回答,在 Windows 上比人们以为的挑:Ollama 硬件页给 Windows ROCm 列了 Radeon RX 7000 和 PRO W7000 家族,而 RX 9000 卡和 R9700 只出现在它的 Linux 清单上。在 Windows 上这些卡走 Vulkan,后端装好后 Ollama 默认启用。这听起来像残废,其实不是:一项在 9070 XT 上的测试里,llama.cpp 走 Vulkan 在 9B 模型上每秒 62 token,还快过一套给这张卡缺原生内核的 ROCm 栈。DirectML 是更老的 Windows 原生路,按微软 Copilot+ 指南正被 Windows ML 取代,这些运行时不用它。
在 Windows 上你的模型到底跑在哪个后端(综合 Ollama 硬件页与 llama.cpp 构建文档;列依次为:GPU|Ollama|llama.cpp|CSuite):
NVIDIA GeForce / RTX PRO|CUDA(驱动 550+)|CUDA 或 Vulkan|CUDA
AMD Radeon RX 7000|ROCm(在 Windows 清单上)|HIP 或 Vulkan|Vulkan
AMD Radeon RX 9000 / R9700|Vulkan(ROCm 此处仅 Linux)|Vulkan,或自行编译 HIP|Vulkan
Strix Halo Radeon 8060S|Vulkan|Vulkan|Vulkan
Copilot+ NPU|不用|不用|不用
CSuite——本博客所属的桌面应用——内置 Ollama 并自动做同样的选择:在 Windows 上只在发现 NVIDIA GPU 时保留 CUDA 运行时,始终带 Vulkan 后端,所以 AMD 或 Intel 卡不用设置就被加速。Windows 版在三种形状上装法都一样;在 NPU 台式机上它就只是跑在核显上,慢。
WSL2 跑只支持 Linux 的工具。有些训练和服务工具先为 Linux 打包。Windows 子系统 Linux 会把 GPU 透传过去,NVIDIA 的 CUDA on WSL 指南对唯一那条规则说得很重:装 Windows 的 NVIDIA 驱动,别的都别装,不要在 WSL 里装任何 Linux 显示驱动。微软的 WSL GPU 页补充,一台多 GPU 机器一次只能给 WSL 暴露一块。日常跑模型你不需要 WSL;Ollama 和 llama.cpp 是原生 Windows 程序。
盒子的其余部分:内存、电源,以及为什么双卡通常不划算
系统内存。塔式机里模型住在卡的显存里,所以系统内存不是那个头条数字。但它仍然重要:一个略超显存的模型可以把层溢到内存里、慢慢跑下去。16 GB 卡配 32 GB 系统内存是地板,32 GB 卡配 64 GB 是正解,联想和惠普的 5090 配置就是这样。别为了“帮”显卡去买 128 GB 系统内存,帮不上。
电源和风道。NVIDIA 规格页是这事儿的准绳:单是 RTX 5090 就抽 575 W,要求 1000 W 系统电源;5080 要 850 W,5070 Ti 要 750 W。品牌整机是按它随附的卡配好的,所以这个问题只在你以后想升级时咬人。一台随 5070 Ti 和 750 W 电源卖出的中塔,不换电源——往往还要换更大机箱——就上不了 5090。生成会让卡满载几分钟、比大多数游戏都长,所以前面进风、顶部出风的机箱比灯效值钱。
两张卡。把两张 16 GB 卡拼成 32 GB 这个念头一直冒出来,却很少过得了算术关。运行时能把模型拆到两张卡上,但第二张卡加上它自己的功耗、插槽和价钱,两半之间要过主板而不是共享一条内存总线。两张 5070 Ti 按街价几乎是一张 32 GB R9700 指导价的两倍,功耗翻倍,还要一块带两条走线正确的插槽的板子——几乎没有品牌整机有。你需要 32 GB,就一张卡买够,或者买迷你主机。
三档预算的短名单
下面是形状和卡档,不是具体型号,因为下周有货的 SKU 会变,形状不会。花钱前先拿计算器对照自己的模型野心。
约 2000 美元 · GPU 塔式机:带 RTX 5070 Ti 或 RX 9070 XT 的品牌整机;16 GB 显存、32 GB 内存;8B 到 14B 全速、20B MoE、图像模型。这一档所有主流产品线都停在 16 GB,所以买最快的 16 GB 卡,跳过 12 GB 的 5070。
约 3000 美元 · 统一内存迷你主机:128 GB 的 Strix Halo 盒子(EVO-X2、Z2 Mini G1a、Framework);96 GB 给 GPU、256 GB/s;70B 稠密慢跑、120B MoE 读速。这是 32 GB 以上、不用五位数显卡的唯一 Windows 形状。单位 token 比塔式机慢,但装得下。
5000 美元以上 · GPU 塔式机:带 RTX 5090 的品牌整机(Area-51、OMEN MAX 45L、Legion Tower 7i);32 GB 显存、64 GB 内存、1000 W;32B 稠密每秒 60+ token,更小的都快。通往 32 GB 最快的消费级路。单是这张卡街价就接近 6000 美元,所以品牌整机更划算。
读这篇时两页内容贯穿始终。24 GB 这一档——27B 到 32B 模型的甜点——在全新 Windows 桌面卡上不存在,所以买家在 16 GB 和 32 GB 之间选,而机箱决定是哪一个。而且内存是正在变贵、不是变便宜的部件,所以你现在买的盒子,就是你要跑好几年的盒子。定好你想跑的模型大小,在总览里找到那一档,买下拥有那一档的形状。机箱正面的贴纸爱写什么写什么。
如果你还带一台笔记本,或者桌子是一台 Mac,同样的逻辑贯穿笔记本篇和 Mac 篇——在那边统一内存是默认而不是例外。 |

 匿名
发表于