KDZNR网

 找回密码
 立即注册
搜索
热搜: 活动 交友 discuz
查看: 15|回复: 0

AI 推理服务商解析:五类平台怎么挑

[复制链接]
匿名
匿名  发表于 昨天 18:03 |阅读模式
“推理服务商”是一个词,却指五门生意。该握紧哪把钥匙,取决于你生成的是什么。价格取自十二家厂商页面。

选好一个模型,下一个问题在第一个问题还没定之前就来了:它跑在哪儿?同一个开放权重文本模型,下面至少三个平台都在卖,输入价相差接近四倍。你刚挑好的图像模型,躺在三个目录里、用三种不同的价格单位。它们统称“推理服务商”,而这是一个词指五门不同的生意。


本文画出这五种形状,再各走一遍每一类里的头部平台,数字都取自厂商自家定价页。读完你该知道该握哪一把、或哪几把钥匙。对大多数同时生成文本、图像、音频和视频的人,简短答案是:一个媒体托管、一个路由、再加一个本地运行时,能留在本机上的都留给本机。

服务商是模型跑的地方,这是一个独立的选择

模型厂商训练权重:OpenAI、Anthropic、Google、Meta、DeepSeek、字节跳动。推理服务商拥有这些权重所跑的 GPU,按 token、按张图或按秒把产出卖掉。有时厂商和服务商是同一家:OpenAI 自己托管 GPT-5.6。常常不是:Meta 训练了 Llama,却不为你托管其中任何一份,而 Together、Fireworks、Groq、DeepInfra 和 Amazon 都在托管。字节的 Seedream 图像模型在 Runware、fal 和 Replicate 上,三种定价。

网关(或称路由)是第三样东西:一个接线总机,握着许多家服务商的钥匙,在一个 API 后面转售。这里把 OpenRouter 当成五选一的一种服务商形状。

形状之所以重要,是因为它们定价方式不同、托管东西不同、出故障的方式也不同。媒体托管按产出计费,生成失败不收钱。GPU 托管按 token 计费,对它之前见过的输入给更便宜的价。超大规模云厂商通过你财务团队已经在付的云账户计费。

媒体托管按张图或按秒收钱

如果你生成图像、视频或音频,先看价格单位,再看价格。按张图定价,你在生成之前就知道一张图多少钱。按秒算的 GPU 价,只有等你知道模型跑了多久才知道花了多少——而对扩散模型,这随分辨率、步数和模型是否预热而变。这两种单位在下面三个平台上都存在,有时就在同一页。

Runware(媒体托管)。托管图像、视频、音频、3D、编辑和超分,外加一个文本模型副目录。首页计数:198 个图像模型家族、114 个视频、29 个音频,算上社区权重有 40 万+ 模型。定价按产出:图像生成每张 0.0006 到 0.24 美元,随模型、分辨率和质量而定;无服务器计算也按秒卖:H100 每秒 0.000767 美元,B200 每秒 0.001386 美元。付费即用,无预付门槛;企业邮箱送 2 美元额度、不用绑卡;只有成功请求才收费。强项:一个固定的按产出价背后,媒体模型最广。真实边界:文本模型是副目录,不是主菜;除了那 2 美元没有免费额度。

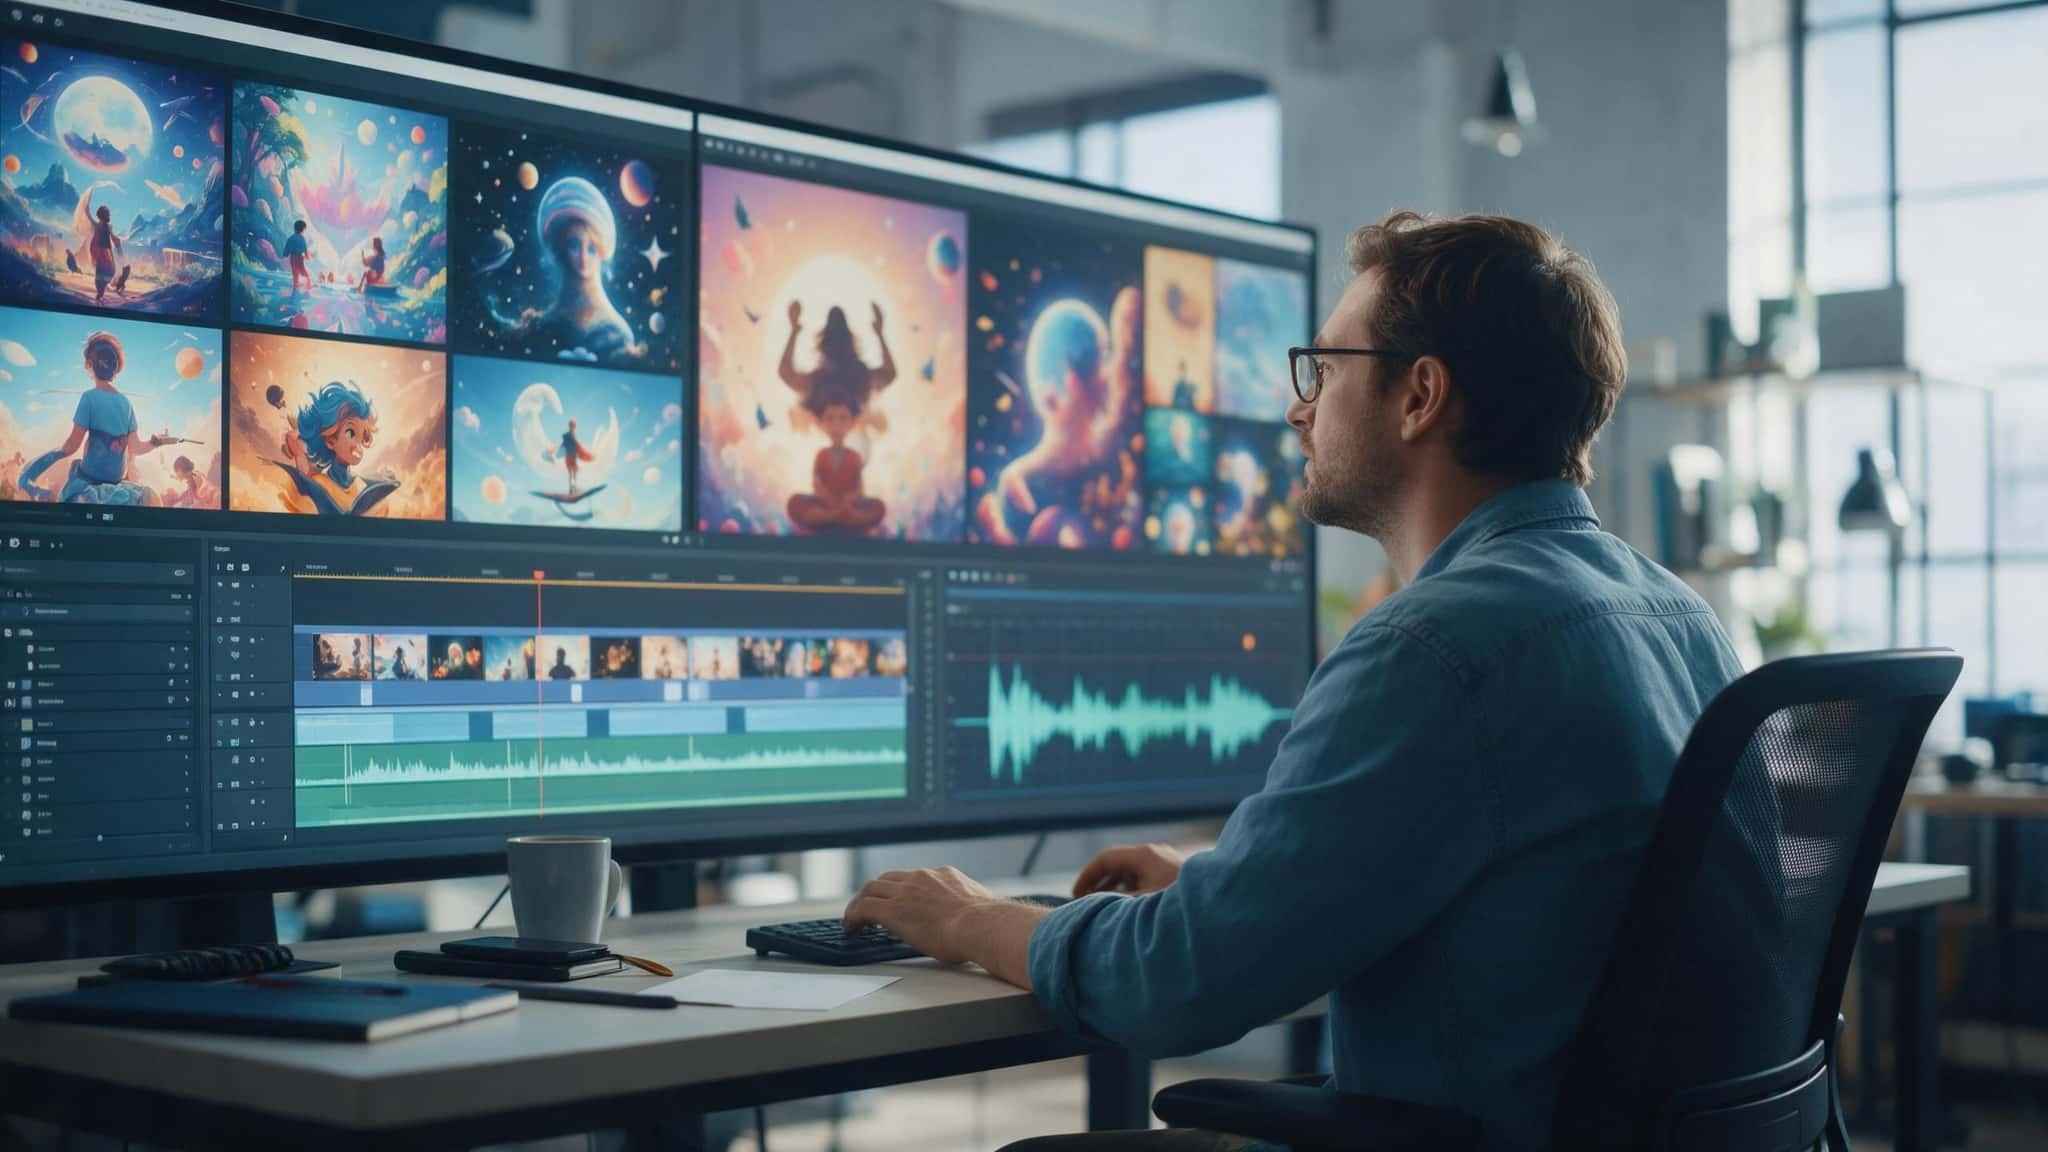
本文写作用的四张插图就来自 Runware 的 API:Seedream 5 Pro、2560×1440、各取第一份,四张共 0.39 美元,每张 46 到 59 秒。这就是按产出定价的全部意义:数字在请求发出去之前就知道了。

Replicate(媒体托管)。“社区贡献的数千个模型”,外加 OpenAI、Google、Anthropic、Black Forest Labs 的官方模型,横跨图像、语音、音乐、视频和语言模型。定价一页两单位:社区模型按硬件时间算,T4 每秒 0.000225 美元、A100 80GB 每秒 0.0014、H100 每秒 0.001525(每小时 5.49 美元);官方模型按产出算,FLUX Dev 每张 0.025 美元、FLUX Pro 0.04、Ideogram v3 0.09、Wan 视频按输出每秒 0.09 到 0.25 美元。预付额度或每月后付。公开模型安装和空闲时间免费,失败运行不收钱。部署给你一个常驻实例的私有端点,代价是安装和空闲时间也开始计费。强项:长尾。一个研究员上周刚发的模型,多半就在这儿。真实边界:长尾上共享硬件意味着冷启动;而解法——部署——把计费单位从按产出改成按小时。

fal(媒体托管)。“1000+ 个可直接用于生产的图像、视频、音频和 3D 模型”。按产出:Seedream V4 每张 0.03 美元、FLUX Kontext Pro 0.04、Qwen 图像每兆像素 0.02;视频按秒,Wan 2.5 每秒 0.05、Kling 2.5 Turbo Pro 0.07、Veo 3 每秒 0.40;裸 GPU 从每小时 1.89 美元的 H100 起。只用多少付多少,我们读的页面上没标免费额度。强项:扩散速度,fal 自称推理引擎快 up to 10 倍,这是厂商说法,我们没测。真实边界:只做媒体,没有值得为它单独握一把钥匙的文本目录。

开放权重 GPU 托管把文本变成了大宗商品

开放权重文本是 AI 里竞争最激烈的市场。同一个 DeepSeek V4 Flash 权重在这四家平台上都有,输入价从每百万 token 0.06 到 0.22 美元不等,看你问哪一家。它们每一家都说 OpenAI 请求格式,所以切换就是改一个 base URL 和一个模型名。这就是为什么价格趋同,也是剩下的差别为什么是速度档、缓存折扣和计费条款。

Together(开放权重 GPU 托管)。托管开放文本、视觉、图像、音频、视频和嵌入模型,外加专属端点、GPU 集群和微调。按百万 token:DeepSeek V4 Flash 输入 0.14、输出 0.28;Llama 3.3 70B 双向各 1.04;GLM-5.3 输入 1.40、输出 4.40;Kimi K3 输入 3、输出 15。图像每张 0.0006 到 0.134。按需 H100 促销价每小时 3.99 美元(标准 5.49)。强项:一个账户里全套,从无服务器到预留集群到微调。真实边界:价格。它的 Llama 3.3 70B 标价比 DeepInfra 同权重贵十倍。

Fireworks(开放权重 GPU 托管)。托管开放文本和视觉模型、Whisper 音频、FLUX Kontext 图像、嵌入、微调。每个模型三档无服务器。标准档:DeepSeek V4 Flash 输入 0.22、输出 0.66;DeepSeek V4 Pro 输入 1.32、输出 3.96,缓存输入 0.044;gpt-oss-120B 输入 0.15、输出 0.60;Kimi K3 输入 3、输出 15。Priority 贵约 25%;Kimi K3 的 Fast 档是输入 4.50、输出 22.50。按 token 后付,送 1 美元起步额度。强项:按请求选延迟,同一个模型有便宜车道和快速车道。真实边界:快速车道贵 50%,而且按需 GPU 涨到每 H100 小时 8 美元。

Groq(开放权重 GPU 托管)。在自家 LPU 硬件上跑一份短名单的开放文本模型和语音模型。模型表:gpt-oss-120B 输入 0.15、输出 0.60、约每秒 500 token;gpt-oss-20B 输入 0.075、输出 0.30、约每秒 1000;Llama 3.1 8B 标每秒 560 token,价格联系销售。有速率受限的免费版,和带批量与 flex 处理的付费 Developer 版。强项:每秒 token 数。这张表里没有第二家把速度印在价格表上。真实边界:只做文本和语音,目录小;NVIDIA 曾授权 Groq 的推理技术、创始人也过去了,Groq 称 GroqCloud 会作为独立公司继续不间断运营。


DeepInfra(开放权重 GPU 托管)。托管开放文本、嵌入、重排、图像、语音、音乐和视频模型,现在也按指导价转售 Anthropic 和 Google 的闭源模型。本组最低标价:Llama 3.1 8B 输入 0.02、输出 0.04;Llama 3.3 70B 输入 0.10、输出 0.32;DeepSeek V4 Flash 输入 0.06、输出 0.18;DeepSeek V4 Pro 输入 1.30、输出 2.60。FLUX-2 Pro 图像每张 0.015。Flex 车道 0.8 倍底价,Priority 车道 1.5 倍。任何请求跑之前都要绑卡或预付余额,没标免费额度。强项:价格。模型开放、你又受得了 Flex 车道,这里通常就是地板。真实边界:没有免费档试,它转售的闭源模型和原价一样。

路由用广度收 5.5% 手续费

OpenRouter 自己不拥有 GPU。它握着上面那些托管和第一方 API 的钥匙,在一个 OpenAI 形状的钥匙后面把它们全转售。Stripe 收购它的公告把数字定在来自 80 多家服务商的 400+ 模型。

OpenRouter(路由)。托管文本和视觉的聊天补全,外加图像生成、视频生成、TTS 和转录的专属端点。定价就是服务商自己的价、推理不加价;用卡买收 5.5%(最低 0.80 美元),用加密货币 5%;自带服务商钥匙,则在月度额度之上收同一调用在 OpenRouter 上费用的 5%。预付额度。免费档模型每天 50 次请求,买过 10 美元额度后每天 1000 次。一家服务商挂了自动切下一家;后缀 nitro 要最快吞吐,floor 要最低价。强项:一把钥匙、一张账单、一种请求格式,服务商列表每周变也不用动代码。真实边界:它不可能比它握的最便宜服务商加手续费还便宜,它修不了服务商的冷启动,而且它现在归一家支付公司了。

第一方 API 卖独占,超大规模云厂商卖采购

有些模型发布当天你在别处拿不到,而前沿模型的头几周往往是产品决策唯一重要的几周。这就是第一方生意。价格公开,折扣是结构性的:缓存输入和批量处理,而不是谈出来的。

OpenAI:GPT-5.6 Terra 每百万 token 输入 2、输出 12;GPT-5.6 Sol 输入 4、输出 20;GPT-6 Astra 输入 10、输出 50;缓存输入按输入价的十分之一。gpt-image-2 的图像输出每百万输出 token 30 美元。批量半价。

Anthropic:Haiku 4.5 输入 1、输出 5;Sonnet 5 输入 2、输出 10;Opus 5 输入 5、输出 25;Fable 5.1 输入 10、输出 50。缓存读取把输入压到每百万 0.10 到 0.50;批量五折。

Google:Gemini 3.8 Flash 优惠期内输入 0.75、输出 3.75,之后恢复 1.50 和 7.50;Gemini 2.5 Flash-Lite 输入 0.10、输出 0.40。有免费档,注明内容可能被用于改进产品。Veo 3.1 视频每秒 0.05 到 0.60 美元,Gemini 2.5 Flash Image 每张 0.039 美元。

超大规模云网关把同样的模型卖给另一类买家。Amazon Bedrock 的模型目录列了 18 家服务商,从 Anthropic、OpenAI 到 DeepSeek、Qwen、Mistral、xAI 和 Z.AI,按 token 按需计费、批量半价、或按一个月和六个月期的预留吞吐出售。Google 的 Vertex AI(文档现在归在它的 Gemini 企业代理平台名下)把 Claude Fable 5.1、Opus 5、Sonnet 5 和 Gemini 放在一起,有 Standard、Priority、Flex 按需车道和预留吞吐。Microsoft Foundry 称有 11000+ 模型,包括 OpenAI、Anthropic、Meta、Google 和 xAI,按服务计费。

你从超大规模云厂商买的不是模型。是一张发票、一套身份系统、一个数据驻留选择和别人已经签好的合规文件。你放弃的是路由的广度和 GPU 托管的便宜。你看到的价是指导价,而你想要的模型有时在它到达源头之后才到那儿。

整张地图一张表

按对你重要的那一列读这张表。如果你生成图片,“计费单位”那一列说了算。如果你大批量跑一个开放文本模型,“权重”和“免费”把它收窄到四行,上面的价格卡再定胜负。如果你需要采购走签字,只有最后一行适用。

十二家平台、七列(列依次为:平台|形状|模态|权重|计费单位|OpenAI 接口|免费额度|强项):

Runware|媒体托管|图/视频/音频/3D/文本|开放+闭源|按产出;GPU 按秒|兼容层|$2 免绑卡|固定按产出价下最广的媒体目录
Replicate|媒体托管|图/视频/音频/文本|开放+闭源|按秒或按产出|自家 API|部分模型免费|长尾,人人可发模型
fal|媒体托管|图/视频/音频/3D|开放+闭源|按产出;GPU 按小时|自家 API|未标注|扩散速度,按产出的视频价
Together|GPU 托管|文/图/音/视频|开放|按百万 token|是|未标注|无服务器到集群到微调
Fireworks|GPU 托管|文/视觉/图/音|开放|按百万 token,分档|是,另加 Anthropic|$1|按请求选标准/优先/快速
Groq|GPU 托管|文/语音|开放|按百万 token|大体兼容|免费档|每秒 token 数
DeepInfra|GPU 托管|文/图/音/视频|开放+转售闭源|按百万 token,×0.8 到 ×1.5|是|未标注|本组最低标价
OpenRouter|路由|文/图/视频/语音|开放+闭源|服务商价 + 5.5%|是|免费模型 50/天|80+ 服务商 400+ 模型一把钥匙
OpenAI|第一方|文/图/音/视频|闭源(含 gpt-oss)|按百万 token|就是标准|未标注|源头的 GPT-5.6 和 GPT-6
Anthropic|第一方|文/视觉|闭源|按百万 token|自家 SDK|未标注|源头 Claude,缓存折扣最深
Google Gemini API|第一方|文/图/视频/音|闭源(含 Gemma)|按百万 token|兼容端点(beta)|免费档|最便宜的前沿档,有免费档
AWS Bedrock / Vertex / Foundry|超大规模云|按模型全模态|开放+闭源|按 token;预留|不一|云额度|一张发票一套身份

“OpenAI 接口”指该平台在不同 base URL 下接受 OpenAI 请求格式。“免费”是厂商在定价或文档页上写明的;“未标注”是我们在那儿没找到,不是说没有。

下面的需求清单是同一张表倒着读,从需求到钥匙。假设你是自己付账单的开发者或重度用户;已有云合同的公司应从最后一行开始。

按你要什么,握哪把钥匙:

一切文本、一把钥匙|OpenRouter|400+ 模型、OpenAI 请求格式、自动故障切换;在服务商自家价上加 5.5%
最便宜的开放文本模型|DeepInfra 或 Groq|DeepSeek V4 Flash 在 DeepInfra 输入 0.06、输出 0.18;gpt-oss-20B 在 Groq 输入 0.075、输出 0.30
最快的文本|Groq|gpt-oss-120B 约每秒 500 token,gpt-oss-20B 约每秒 1000
最广的图/视频/音频|Runware,其次 fal 或 Replicate|固定按产出价、主流媒体模型全覆盖、生成失败不收费
别处没有的前沿模型|第一方 API|GPT-6 Astra、Claude Fable 5.1、Gemini 3.8 Flash 先到源头,云和路由随后
企业采购|Bedrock、Vertex 或 Azure Foundry|一张云发票、现成身份与合规、预留吞吐;为便利付指导价

表展示不了两件事。第一,按产出价和按 token 价在你知道任务之前不可比。第二,这里每个数字都会动:Gemini 3.8 Flash 优惠结束后翻倍;Fireworks 近期上调了按需 GPU 价;Together 的 H100 价是促销。把这些卡当成带链接的快照,不是合同。

三把钥匙加一个本地运行时,几乎覆盖一切

地图怎么变成决定。握一把媒体托管钥匙,因为按产出定价对图片、视频和声音是诚实的单位。握一把路由钥匙,因为开放文本是大宗商品,路由让你跟着价格走而不改任何代码。给一切小到能留在本机上的东西跑一个本地运行时——这比多数人以为的多。只在模型独占时加一把第一方钥匙,只在采购要求时加一把超大规模云。

这就是 CSuite 围绕的形状。这个桌面应用把 Runware、Replicate、OpenRouter 作为云平台,和本地 Ollama、Hugging Face、GGML 运行时并列。一个模型在目录里只出现一次,旁边列着能跑它的平台,所以同一个 Seedream 或 DeepSeek 条目随你握哪把钥匙都能跑。钥匙从不离开本机:它们存在应用本地数据库里,经操作系统钥匙串加密——macOS 是 Keychain,Windows 是 DPAPI,Linux 是 Secret Service。

提供商这个问题在你回答之后也不会消失。价格会动,目录会变,一家去年还不拥有一块 GPU 的公司,今年就归一家支付公司了。但一旦你不再把“提供商”当成一个词,事情就变简单了。里面是五门生意,每一门都对应一把你该握的钥匙。
回复

使用道具 举报

您需要登录后才可以回帖 登录 | 立即注册

本版积分规则

Archiver|手机版|小黑屋|KDZNR网

GMT+8, 2026-9-26 22:29 , Processed in 0.053115 second(s), 20 queries .

Powered by Discuz! X3.4

© 2001-2023 Discuz! Team.
快速回复 返回顶部 返回列表