KDZNR网

 找回密码
 立即注册
搜索
热搜: 活动 交友 discuz
查看: 25|回复: 0

本地 AI 笔记本选购:Mac、Windows、Linux 对比

[复制链接]
匿名
匿名  发表于 昨天 18:07 |阅读模式
笔记本显卡显存停在 24 GB,而统一内存还在往上爬。每个平台一个数字,决定你的笔记本这辈子能跑什么。

走进笔记本卖场,说“要一台能跑 AI 的”。店员会塞给你一台游戏本,带 RTX 贴纸、碟子大的风扇、8 GB 显存。它跑 8B 模型很漂亮,跑 32B 模型根本跑不动。一台同样价位、安安静静的 32 GB MacBook Air 却能跑那个 32B。两台机器都没错。它们站在不同的梯子上,而店员只认识其中一架。


这就是今年买便携机跑本地 AI 的全部麻烦。决定只有一个数字,但这个数字在每个平台上名字不同:Apple 芯片和 AMD Strix Halo 上叫统一内存,任何带独显的笔记本上叫显存。两者不能一比一换算。而 AI 热潮让内存成了整台机器里最稀缺的部件,你今年买的这个数字,就是这台机器这辈子的天花板。
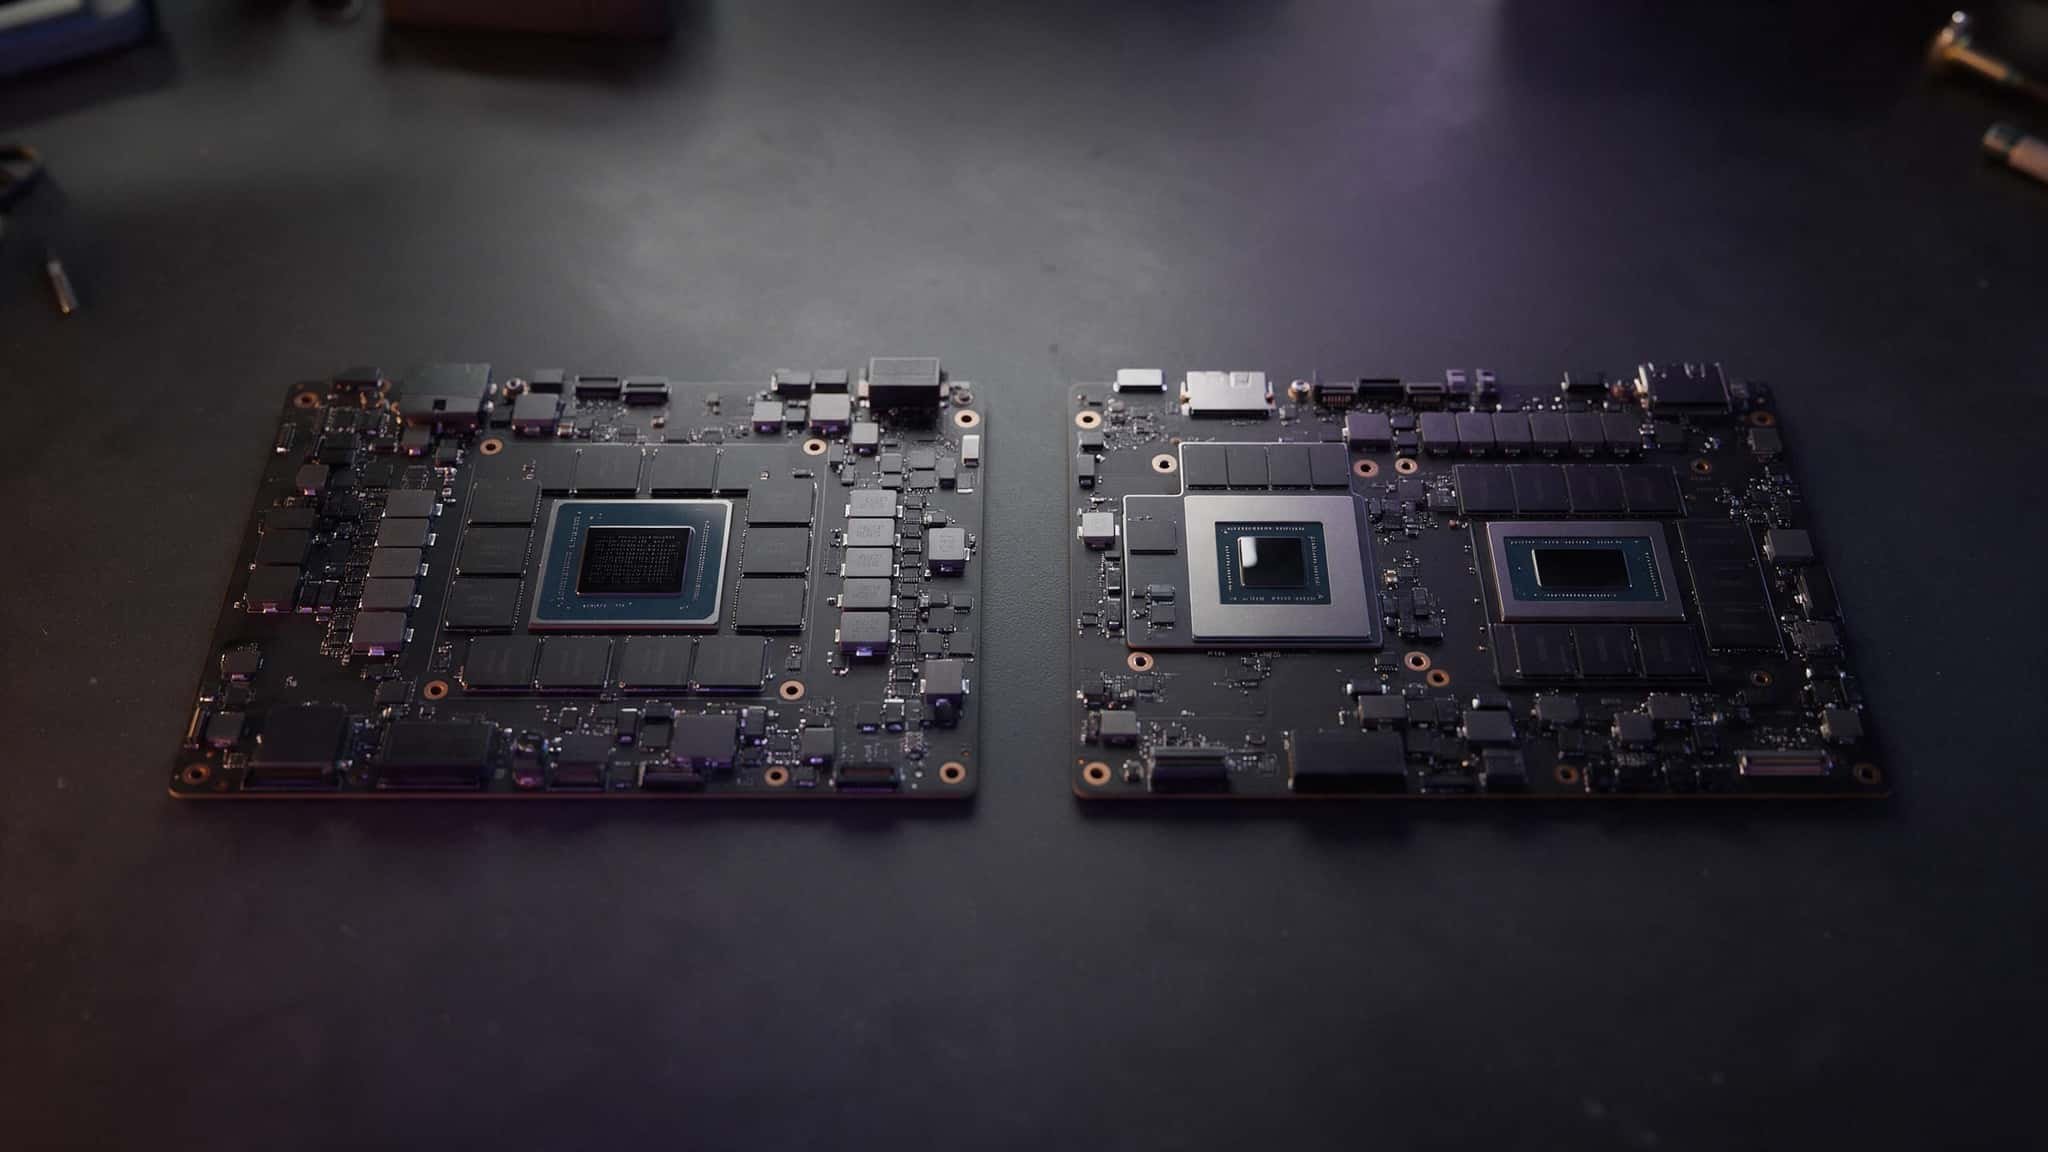
短版本:约 16 GB 以下,独显每块钱更快;越过它,统一内存笔记本直接胜出——因为没有任何笔记本显卡越过 24 GB,而统一内存一路到 128。

内存是悬崖,笔记本的内存一辈子改不了

语言模型必须整个躺在 GPU 跑的时候能摸到的内存里。一个要 20 GB 的模型,在 16 GB 机器上不是慢一点,而是要么拒绝加载、要么溢到 SSD 上每隔几秒吐一个词。这就是为什么本篇每张表都按内存排,不按跑分排。背后的算术就一行:一个 4-bit 模型每十亿参数约需 0.6 GB,再加几个 GB 给对话本身。

在笔记本上,这道悬崖是永久的。苹果把内存焊在芯片封装上,明说之后不能升级。Strix Halo 笔记本一样:华硕把 Flow Z13 的 32、64、128 GB 档列为板载 LPDDR5X 8000。而显卡的显存顾名思义是固定的,哪怕在 Framework Laptop 16 那种整块 GPU 模块可换的机器上。你在结账时跳过的升级,就是永远跳过。

时机让它更糟。内存厂商把消费级产线转去做数据中心部件,笔记本厂商被警告来年指导价至少涨两成。苹果随后把涨价落到实处:13 寸 MacBook Air 从 1099 涨到 1299 美元,14 寸 M5 Max 从 3599 涨到 4099 美元。Framework 一块 8 GB 的 RTX 5070 模块收 699 美元,同芯片 12 GB 版收 1199 美元。4 GB 内存现在值 500 美元。请 deliberate 地买内存。

两架内存梯子,彼此不能换算

这就是卖场从不解释的换算。在 Mac 上,CPU 和 GPU 在同一封装里共享一个内存池,macOS 默认让图形层用其中约 75%。对跑模型这件事,一台 32 GB MacBook 就是一张 24 GB 显卡;一台 64 GB MacBook Pro 是一张 48 GB 的;一台 128 GB M5 Max 是一张 96 GB 的——比任何消费级显卡(无论桌面还是笔记本)出货时带的都多。

AMD 的 Strix Halo 芯片(卖作 Ryzen AI Max)在 Windows 和 Linux 上同理。Ryzen AI Max+ 395 把 16 个 CPU 核和一颗 40 单元 Radeon GPU 放在一个封装上,由 256 位 LPDDR5X-8000 总线喂;在 128 GB 机器上你可以专门分给 GPU 最高 96 GB,和 Mac 一样的 75% 法则,只是从另一头到达。Framework 的桌面版这颗芯片引用的是同一个 96 GB 上限。

带独显的笔记本站在另一架梯子上。模型必须装在卡自己的显存里,NVIDIA 按档位配给:RTX 5050、5060 和基础版 5070 是 8 GB;5070 Ti 是 12 GB;5080 是 16 GB;5090 是 24 GB。这就是整架梯子。24 GB 以上没有下一级,不论什么价、不论哪台笔记本。游戏本里那 64 GB 系统内存帮不上忙,因为模型从显存溢到系统内存要过一条窄 PCIe 通道,慢到爬。AMD 自己的独显笔记本线最高停在 16 GB,带它的机器又少,所以实际上显存梯子就是 NVIDIA 的。

把两架梯子并排放,交叉点一目了然。8 GB 卡和 16 GB Mac 都装得下 8B;12 GB 卡和 24 GB Mac 都装得下 14B;24 GB RTX 5090 笔记本和 32 GB Mac 都装得下 32B。然后显存梯子到头了,统一梯子还有三级。如果你只打算跑 8B 到 14B,“买带 RTX 贴纸那台”的直觉完全正确;如果你心里有个 70B 模型,这个直觉完全错误。

带宽是第二根轴,独显赢在这

内存大小决定能跑什么,带宽决定它说多快。生成文本是个奇怪的负载:每生成一个 token,芯片都要把整个模型从内存读一遍,所以每秒 token 数几乎和管道宽度成正比。苹果自己的机器学习团队在 M5 发布时演示得很清楚:带宽从 M4 的 120 提到 153 GB/s,生成速度涨了 19% 到 27%,几乎正好是管道增长的 28%。

GPU 能读的内存带宽,GB/s(列依次为:平台|机型|带宽):

Panther Lake 核显|Intel 轻薄本|154
Apple M5|MacBook Air、基础 Pro|153
Strix Halo|Ryzen AI Max+ 笔记本|256
Apple M5 Pro|MacBook Pro|307
RTX 5070 笔记本|8 或 12 GB|384
Apple M5 Max|MacBook Pro|614
RTX 5070 Ti 笔记本|12 GB|672
RTX 5080 / 5090 笔记本|16 / 24 GB|896

这就是独显挣回身价的地方。宽总线上的 GDDR7 就是比和 CPU 共享的 LPDDR5X 快:NVIDIA 给 RTX 5080 和 5090 笔记本芯片报 896 GB/s,而 M5 Max 是 614、M5 Pro 是 307、基础 M5 是 153。Strix Halo 的 256 位总线纸面上是 256 GB/s,而一份被广泛引用的社区实测在负载下约 212 GB/s。所以一台 24 GB RTX 5090 笔记本和一台 32 GB MacBook Pro 装着同一个 32B 模型,但 RTX 笔记本读它大约比 M5 Pro 快三倍。

公开数字和算术对得上。在 llama.cpp 项目 Apple 硅表的标准 7B 4-bit 测试里,M5 约每秒 32 token,M5 Pro 66,M5 Max 120。Strix Halo 机器在同一社区测试里约 53。StorageReview 测一台带 RTX 5090、跑在 135 W 的 Razer Blade 16,经 Ollama 跑 Llama 3 8B 约每秒 108 token,约为桌面 5090 同测的一半。框架不同,下面的数字只当量级,但排序是稳的。

7–8B 模型上的公开生成速度,token/秒(框架和模型略有差别,只当量级;每秒 20 以上就比多数人阅读快):

MacBook Air / Pro M5|llama.cpp 7B Q4_0|32
Strix Halo 笔记本|llama.cpp Vulkan 7B Q4_0|53
MacBook Pro M5 Pro|llama.cpp 7B Q4_0|66
RTX 5090 笔记本 135 W|Ollama Llama 3 8B|108
MacBook Pro M5 Max|llama.cpp 7B Q4_0|120

这张图取两件事。第一,上面所有都比你读得快,所以对 8B 模型带宽是奢侈,不是必需。第二,差距在梯子顶端才要紧。带宽除以模型大小就是上限:一个 43 GB 的 70B 模型在 256 GB/s 的 Strix Halo 上顶到约每秒 6 token,在 614 GB/s 的 M5 Max 上约 14。两台都装得下模型,只有一台让它用着舒服。这就是统一内存买家做的取舍,而 M5 Max 是唯一一台把这个取舍做得很轻的笔记本。

每一档到底能跑什么

模型大小聚成几档,每一档解锁一类不同能力。下面的容量用和硬件计算器同一套 4-bit 估法,并留出上下文余量。苹果 MLX 团队给 24 GB 档一个有用的校准:一台 24 GB MacBook Pro 能跑全精度的 8B 模型,或 4-bit 的 30B 混合专家,整个负载压在 18 GB 以内。

模型大小对内存档(4-bit 每十亿参数约 0.6 GB,加上下文余量;列依次为:模型|4-bit 需|需要哪档|跑在哪):

8B|4.9 GB|8 GB 显存或 16 GB 统一|私密聊天、起草、摘要。本篇所有笔记本。
12–14B|约 8–9 GB|12 GB 显存或 24 GB 统一|写作和代码明显更好。RTX 5070 Ti、24 GB Air。
27–32B|约 17–20 GB|24 GB 显存或 32–48 GB 统一|多数人的日常天花板。RTX 5090 笔记本、32 GB Mac。
70B|43 GB|64 GB 统一|没有笔记本显卡能行。64 GB M5 Pro、64 GB Strix Halo。
120B MoE|约 65 GB|96–128 GB 统一|gpt-oss-120b 那一档。128 GB M5 Max、128 GB Strix Halo。

该圈出来的一行是 70B。它是开放模型不再显得小的那个点,也是显存列第一次出现空格的一行。一台 64 GB MacBook Pro 或 64 GB Strix Halo 笔记本,是能跑它的最便宜便携机。120B 那行是同一个故事往上一级。一位 Strix Halo 机主在 Ollama issue 跟踪里报告,GPU 可用约 110 GB,30B 到 35B 模型 8-bit 生成约每秒 40 token;社区测试集跑 58 GB 的 Llama 4 Scout 约每秒 20。这些都是 24 GB 卡根本启动不了的负载。


按平台看阵容

Mac。在此概括,完整论证见 Mac 篇。MacBook Air 可选 16、24 或 32 GB、153 GB/s,涨价后 1299 美元起。M5 Pro 的 MacBook Pro 到 64 GB、307 GB/s、2499 美元起;M5 Max 到 128 GB、614 GB/s,14 寸 4099 美元起。每个本地运行时都内置 Metal 支持,包括 CSuite 内置的 Ollama,所以没有驱动故事要讲。

Windows 统一内存。三台 Strix Halo 笔记本值得看。华硕 ROG Flow Z13 是一台 1.2 kg 的 13 寸平板,32、64 或 128 GB;128 GB 版在华硕自家店里,美国零售商约 3300 美元。HP ZBook Ultra G1a 是 14 寸工作站版,最高 128 GB,首发价 32 GB 配 4296 美元、满配 8250 美元,街价此后已远低于指导价。华硕 TUF Gaming A14 把更新的 Ryzen AI Max+ 392 放进一台 2200 美元的游戏本,但美版停在 32 GB——这是统一梯子上不该多花钱的那一头。买 Strix Halo 就买 64 或 128 GB,否则别买。

还有一台在货架上、不如说在天际线上。AMD 展示了后继者 Ryzen AI Max 400(代号 Gorgon Halo):同一颗 40 单元 GPU,最高 192 GB LPDDR5X-8533,机型下半年晚些时候上市。一台带它的 16 寸 HP ZBook Ultra 已在跑分库里露面,但尚未发布。如果你的目标是 128 GB 又能等一个季度,等是理性的。

Windows 独显。按显存排,其余忽略。戴尔目录是梯子定价的干净例子:Alienware 16 Aurora 1099.99 美元起、最高 RTX 5070;16X Aurora 配 12 GB RTX 5070 Ti 2199.99 美元起;16 和 18 寸 Area-51 配 24 GB RTX 5090 分别从 3449.99 和 3999.99 美元起。联想、华硕、微星、雷蛇在同样档位卖同样的芯片。RTX 5070 有 8 GB 和 12 GB 两版;listing 没写哪版就当 8 GB 问一句。在 Windows 上,CSuite 内置的 Ollama 在这些卡上走 CUDA,在 AMD 和 Intel 显卡上走 Vulkan。

“别买”档。普通轻薄本带 Intel 或 AMD 核显,和 Mac 一样共享系统内存,但过的是窄管道。Intel Panther Lake 最快的部件顶到 LPDDR5X-9600、约 150 GB/s——一条 M5 级别的管道喂一颗小得多的 GPU,背后既没有 Metal 也没有 CUDA。这些机器跑 8B 模型能到可读速度,对一台通用笔记本来说挺好。但它们不是为本地 AI 该买的东西。任何“AI PC”贴纸里的 NPU 同理:它伺候小的端侧模型,不是本篇说的 12B 到 70B 这一档。

持续推理才是轻薄本输的地方

笔记本 GPU 的名字不是规格。NVIDIA 卖给厂商的 RTX 5090 笔记本芯片,显卡功耗范围是 95 到 150 W,每个厂商在这个范围里挑一个自己机箱压得住的点。薄机器和厚机器带同一张贴纸,跑不同速度。有媒体测一台 ROG Zephyrus G16 的 120 W RTX 5090,比 Schenker Neo 16 里 175 W 版慢 25% 到 30%。同一颗芯片、同样 24 GB,为了薄把四分之一的速度留在了桌上。

推理是持续负载,不是爆发。一份长文档摘要或一批图像生成会把 GPU 钉住几分钟,散不了热的机箱就降频、风扇拉满。在两台同 GPU 的笔记本之间选,买更厚的那台,或评测里引用持续功耗数字更高的那台。向规格表要数字,不要名字。

然后插上电。NVIDIA 的 BatteryBoost 在笔记本拔电瞬间自动开启,把 GPU 压下来省电;华硕文档里 ROG 机器默认行为相同。独显笔记本用电池时是另一台更慢的电脑,而一颗抽 100 W 以上的 GPU 大约一小时就把航司允许随身带的任何电池抽空。统一内存机器——尤其是无风扇的 MacBook Air——才是真能在火车上跑模型的。这是一个和内存无关、却该进决策的真实优势。

Linux 跑同样的笔记本,要做驱动作业

没有 Linux 专用的笔记本硬件。每个厂商一套驱动栈,它决定你第一个周末要花多少 setup。NVIDIA 是低摩擦路:Ollama 支持驱动 550 或更新上任何计算能力 5.0 或更新的卡,覆盖如今在售的每一颗 RTX 笔记本芯片;Ubuntu 26.04 LTS 是第一个在自家仓库带 CUDA 和 ROCm 的版本,跑在 Linux 7.0 内核上。笔记本特有的麻烦是混合显卡:核显驱屏幕,NVIDIA 芯片睡着直到被调用。NVIDIA 驱动用 PRIME 渲染卸载处理这个,而 Ollama 这类计算运行时不靠它也能找到卡,所以实际上装好驱动就通了。

Strix Halo 在 Linux 上能干、还年轻。这颗芯片在 ROCm 命名里是 gfx1151,不在 ROCm 官方支持清单上,今天能用的配方靠 HSA_OVERRIDE_GFX_VERSION=11.5.1 这个覆盖变量和一个新内核。内核版本在这儿不是走形式:社区测试集在 otherwise 相同的系统上发现 Linux 6.14 和 6.15 之间有 15% 的性能差。哪个后端更快在各版本间翻过烧饼——早期测试里 Vulkan 领先,而新版 Ollama 指南推荐 ROCm——所以别想当然,按你的 Ollama 版本查当前指引。预算一个晚上,而且每个内核版本都会让它更短。

Vulkan 是万能兜底。Ollama 在 Windows 上默认启用它,在 Linux 上装好厂商 Vulkan 驱动后也支持它——AMD 和 Intel 核显就是靠这个才有点加速。CSuite 的 Linux 版同样分:文本模型在 NVIDIA 机器上经 Ollama 走 CUDA,而本地图像和视频运行时在 Linux 上只带 Vulkan,所以一台 NVIDIA 笔记本在那儿也走 Vulkan 出图。

三档预算的短名单

下面每档每平台一台。价格会漂,内存短缺期间多半往上漂;选品不会,它们由梯子推出,而梯子由硅片决定。

约 1500 美元 · 8B 到 14B 模型、私密聊天和起草:
Mac:MacBook Air M5、24 GB。安静,4-bit 跑 14B 或 30B MoE。这价位最佳选择。
Windows:RTX 5070 Ti 笔记本、12 GB。这价位最快的 8B 到 14B token;12 GB 卡预期加到约 2000 美元;1100 美元那档是 8 GB。
Linux:同一台 RTX 5070 Ti 笔记本。NVIDIA 是低摩擦驱动路。跳过 8 GB 卡。

约 2500 到 3000 美元 · 日常 32B、够得到 70B:
Mac:MacBook Pro 14 寸 M5 Pro、48–64 GB。64 GB 是能跑 70B 模型的最便宜笔记本。
Windows:ROG Flow Z13、64 GB Strix Halo。统一内存路。RTX 5090 笔记本更快但停在 24 GB。
Linux:64 GB Strix Halo、新内核。新内核上跑得好,setup 预算一个晚上。

4000 美元以上 · 120B 级模型、同时驻留多个模型:
Mac:MacBook Pro M5 Max、128 GB。614 GB/s 让 70B 舒服、120B 级可用。
Windows:HP ZBook Ultra G1a 或 Flow Z13、128 GB。96 GB 给 GPU。或者等等:192 GB Gorgon Halo 笔记本快来了。
Linux:128 GB Strix Halo。唯一装得下 gpt-oss-120b 的 Linux 笔记本,内核 6.15 或更新。

三行合起来就是本篇论点。1500 美元时,显存梯子和统一梯子并驾齐驱,只要 14B 独显赢在速度。2500 美元时,显存梯子已经没档可爬,每一个选品都是统一内存。4000 美元时,剩下的问题只是你要 macOS 上的 614 GB/s,还是 Windows/Linux 上的 96 GB 显存,两个都是好答案。

如果你说不出你会在 128 GB 上跑哪个模型,你就不需要 128 GB。说出模型,在上表里找到它那一行,再往上买一档。然后无论你选了哪架梯子,都现在把内存买够,因为这台机器这辈子都加不了。
回复

使用道具 举报

您需要登录后才可以回帖 登录 | 立即注册

本版积分规则

Archiver|手机版|小黑屋|KDZNR网

GMT+8, 2026-9-26 22:27 , Processed in 0.060938 second(s), 20 queries .

Powered by Discuz! X3.4

© 2001-2023 Discuz! Team.

快速回复 返回顶部 返回列表